
製造業の設計案件、SIer・受託開発、各種エンジニアリング業務では、案件開始前に必要工数を見積もり、その工数をもとに価格、納期、体制などを決めます。
しかし、案件完了後に実績を確認すると「見積300時間に対して実績450時間だった」「部署によって工数超過の頻度が違う」といったズレが生じることがあります。
こうした状態に対し、すぐにAIによる工数予測モデルを作る必要はありません。案件ID、見積工数、実績工数、部署、案件種別などの基本情報が残っていれば、まずどの条件で、どちら向きに、どの程度見積が外れているのかを整理できます。
本記事では、500件の人工完了案件を用いて、MAE(平均絶対誤差)、誤差率、箱ひげ図、部署・案件種別・案件規模別の集計から見積精度を分析します。
記事中の案件・工数・部署差・分析結果はすべて説明用の人工データです。実在企業の見積精度や実績を示すものではありません。
見積工数と実績工数のズレを感覚だけで管理していないか
工数超過が発生すると、「今回は難しい案件だった」「担当者の見積が甘かった」と個別案件の反省で終わることがあります。
しかし、過去案件をまとめて分析すると、「システム開発案件で過小見積が多い」「大型案件では時間単位の誤差が大きい」「ある部署は平均的なズレは小さいが、ばらつきが大きい」といった別の構造が見えることがあります。
工数見積については、案件規模の測り方や上流工程の情報によって見積精度が変化することも報告されています(角田 et al., 2025)。重要なのは、見積結果だけではなく、案件条件と実績を継続的に比較できる状態を作ることです。
見積精度を分析する前に「誤差」を定義する
最初に、記事内で使用する見積誤差の向きを統一します。
見積誤差 = 実績工数 − 見積工数
- 正の値:実績工数の方が多い=過小見積
- 負の値:実績工数の方が少ない=過大見積
- 0に近い:見積と実績が近い
さらに、誤差の方向を無視して「どの程度外れたか」を確認するために絶対誤差を計算します。
絶対誤差 = |実績工数 − 見積工数|
この絶対誤差を全案件で平均した値がMAE(Mean Absolute Error:平均絶対誤差)です。
| 指標 | 確認できること |
|---|---|
| 見積誤差 | 過小見積・過大見積の方向 |
| 絶対誤差 | 案件ごとのズレの大きさ |
| MAE | 平均して何時間程度外れているか |
| 実績/見積比 | 1を超えるほど過小見積側 |
| 見積誤差率 | 案件規模を考慮した相対的なズレ |
今回のケーススタディ:500件の人工完了案件
今回は、部署A~Dの4部署が担当した500件の人工完了案件を作成しました。案件には「定型設計」「個別設計」「システム開発」「検証・解析」の4種別と、小規模・中規模・大規模の案件規模を設定しています。
人工データには、部署Bではやや過小見積になりやすい、部署Cでは平均的な偏りは比較的小さいもののばらつきが大きい、部署Dでは大型案件の割合が高い、といった構造を持たせています。
全500案件のMAEは149.0時間、平均誤差は+82.9時間、誤差中央値は+30.3時間でした。実績/見積比の中央値は1.070で、66.2%の案件が過小見積側となりました。
まず見積工数と実績工数を散布図で確認する
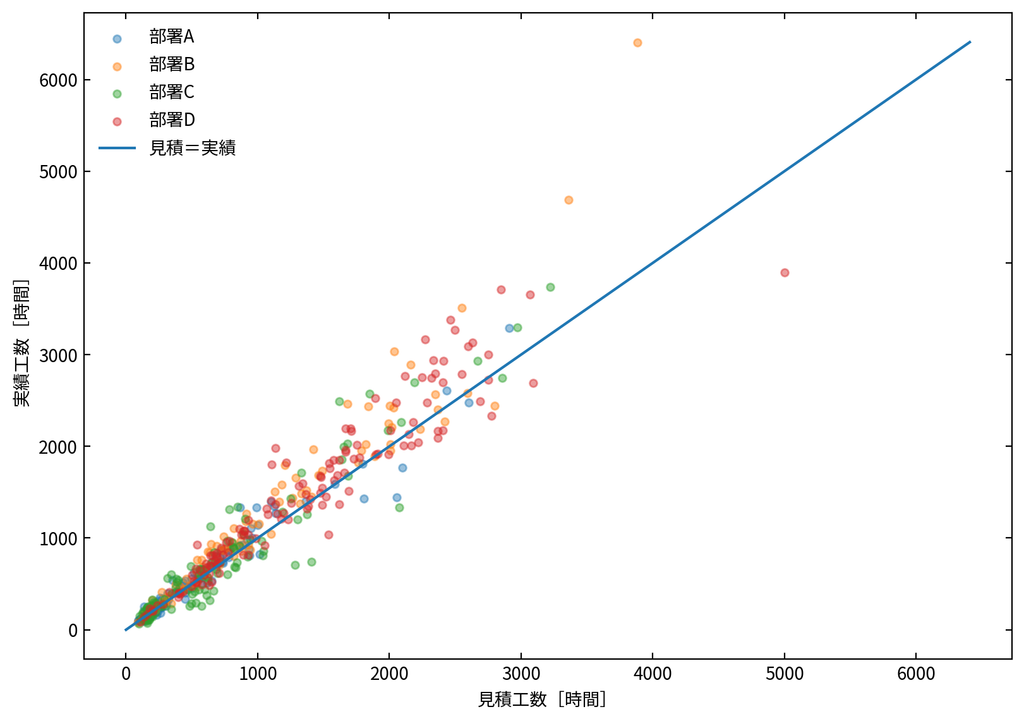
45度線より上側にある案件は実績工数が見積を上回った過小見積、下側は過大見積です。案件規模が大きくなるほど、時間単位のズレも大きくなっていることが分かります。
この時点で重要なのは、単純に「大型案件ほど見積が悪い」と判断しないことです。1,500時間の案件で150時間外れる場合と、150時間の案件で150時間外れる場合では意味が異なります。
MAEで「平均して何時間外れるか」を確認する
今回の人工データのMAEは149.0時間でした。これは、誤差の正負を無視すると、1案件あたり平均して約149時間見積と実績が離れていたことを意味します。
一方で、平均誤差は+82.9時間です。MAEより小さいのは、過小見積と過大見積が一部相殺されるためです。
平均誤差が0時間に近くても、見積精度が高いとは限りません。 +100時間と−100時間の案件が同数存在すれば平均誤差は0になりますが、どちらも見積は100時間外れています。
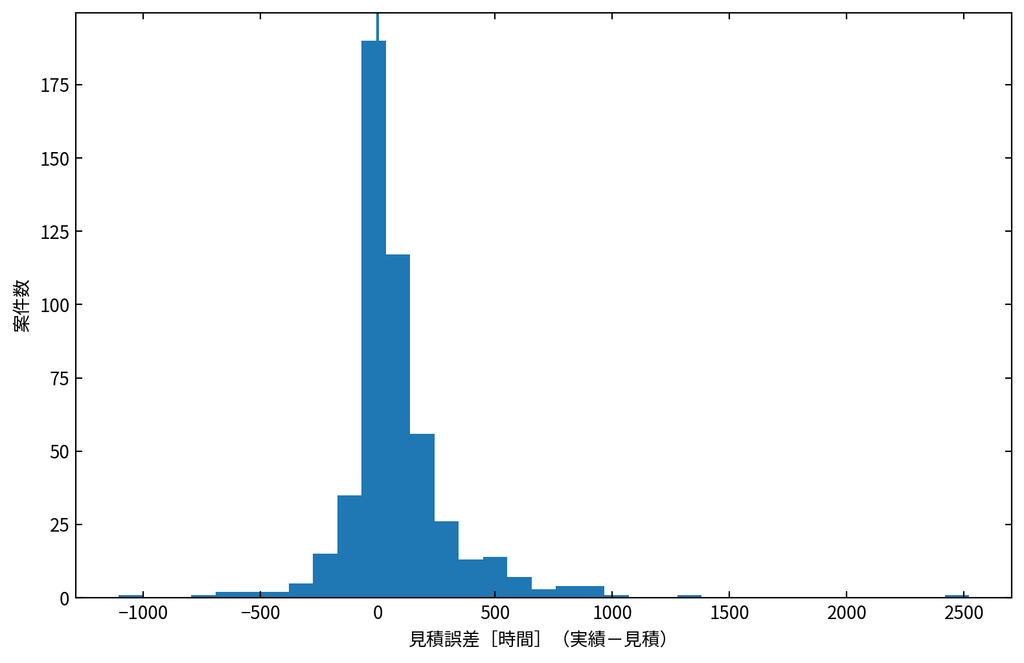
そのため、見積精度を見る際にはMAE、誤差中央値、誤差分布を組み合わせて確認する方が安全です。誤差尺度にはそれぞれ性質があり、尺度依存の指標と割合ベースの指標を単純に置き換えられないことも指摘されています(Hyndman and Koehler, 2006)。
箱ひげ図で部署別の誤差分布を見る
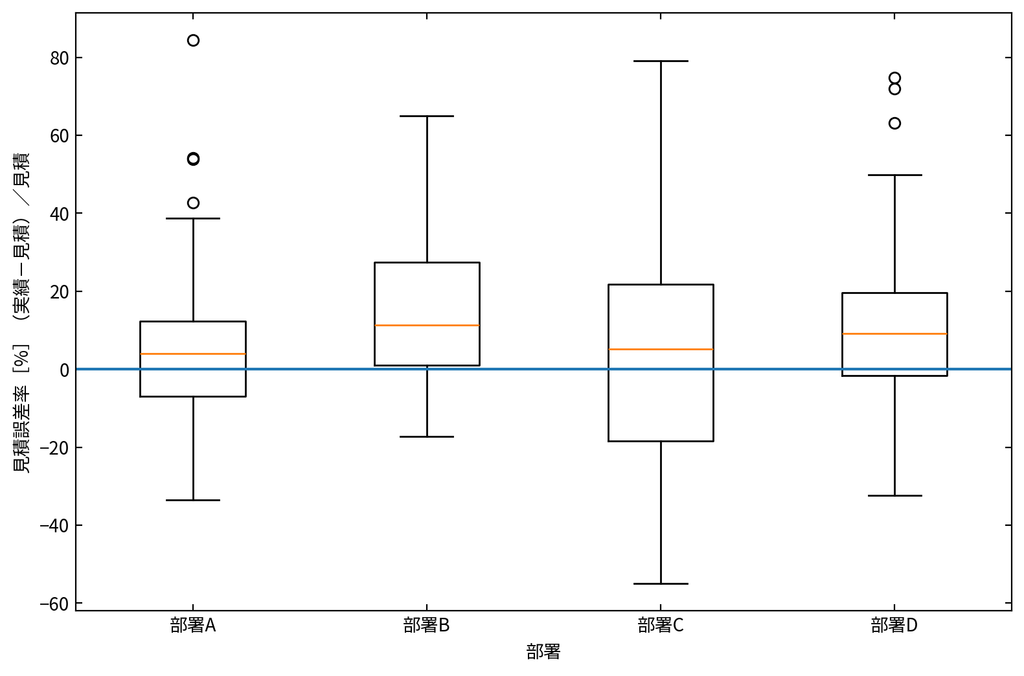
時間単位ではなく「(実績−見積)/見積」で誤差率を見ると、部署の違いが別の形で見えてきます。
部署Bは誤差中央値が+55.2時間、実績/見積比中央値が1.113で、78.7%の案件が過小見積側でした。一方、部署Cの実績/見積比中央値は1.051ですが、絶対誤差率中央値は20.8%と4部署で最も大きく、箱ひげ図でも分布が広がっています。
つまり、部署Bは「一定方向へ過小見積になりやすい」、部署Cは「上下双方へのばらつきが大きい」という異なる問題として捉えられます。
部署別MAEだけで評価すると誤解する
| 部署 | 案件数 | 見積工数中央値 | MAE | 実績/見積比中央値 |
|---|---|---|---|---|
| 部署A | 149 | 262.1時間 | 59.8時間 | 1.040 |
| 部署B | 108 | 734.5時間 | 182.9時間 | 1.113 |
| 部署C | 108 | 581.0時間 | 161.0時間 | 1.051 |
| 部署D | 135 | 1,229.6時間 | 210.7時間 | 1.091 |
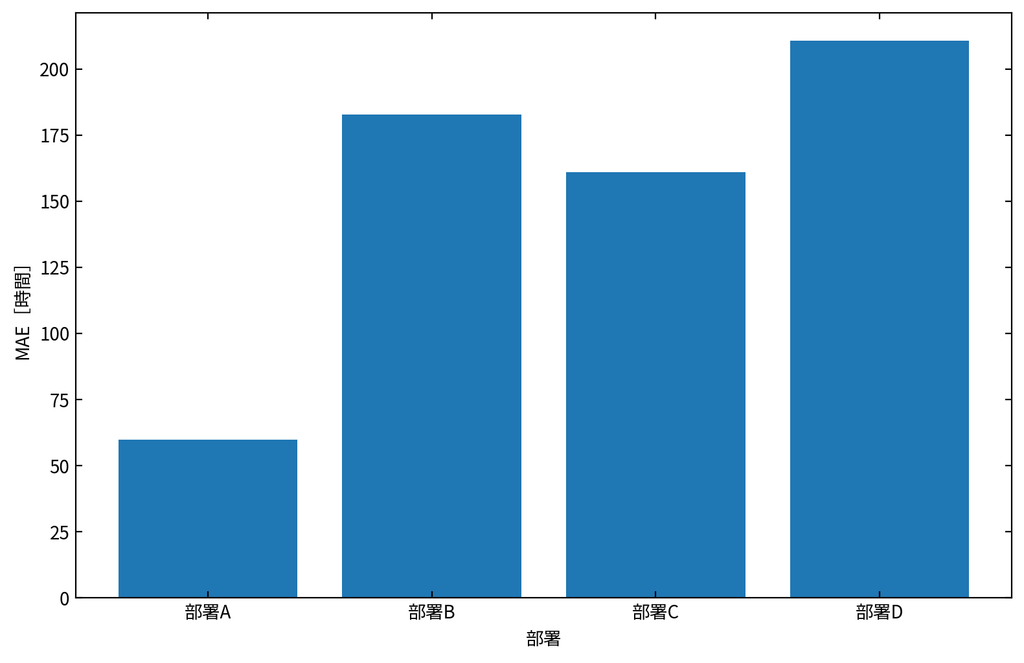
MAEだけを見ると部署Dが210.7時間で最も大きくなります。しかし部署Dの見積工数中央値は1,229.6時間で、他部署より大型案件を多く担当しています。
部署AのMAE59.8時間と部署Dの210.7時間だけを比較し、「部署Aの方が見積能力が高い」と判断することはできません。案件規模の構成が異なるからです。
案件種別で見積誤差を分解する
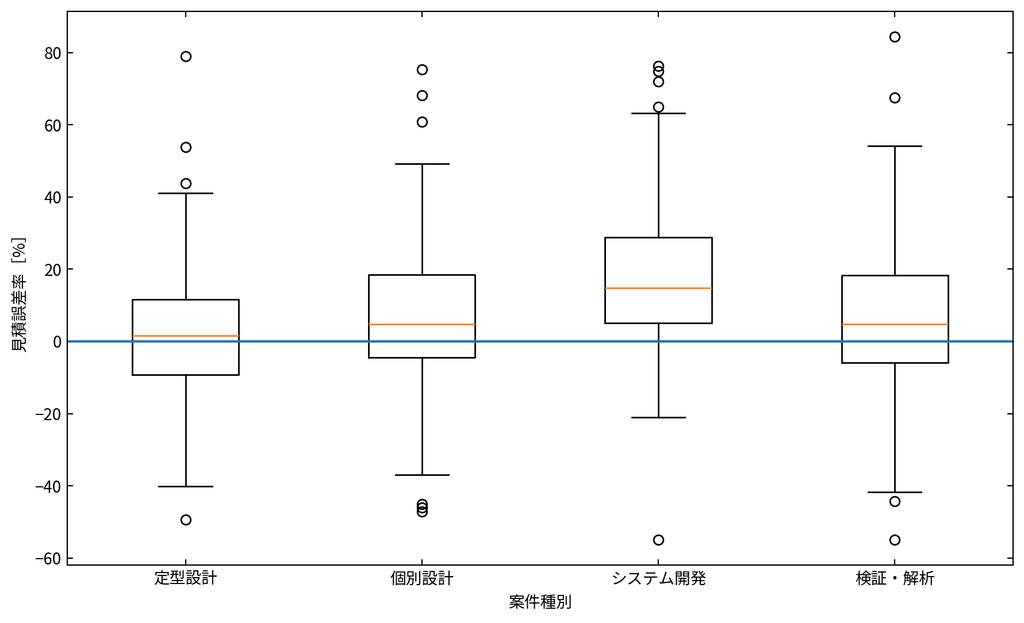
人工データでは、システム開発127案件の実績/見積比中央値が1.148、過小見積割合が82.7%となりました。定型設計では実績/見積比中央値1.016、過小見積割合55.0%です。
この差が見えれば、「部署全体の見積を一律に補正する」より、「システム開発案件では見積レビューを追加する」「類似案件の実績を参照する」といった具体的な改善論点へつなげやすくなります。
大型案件ほど時間単位のMAEは大きくなりやすい
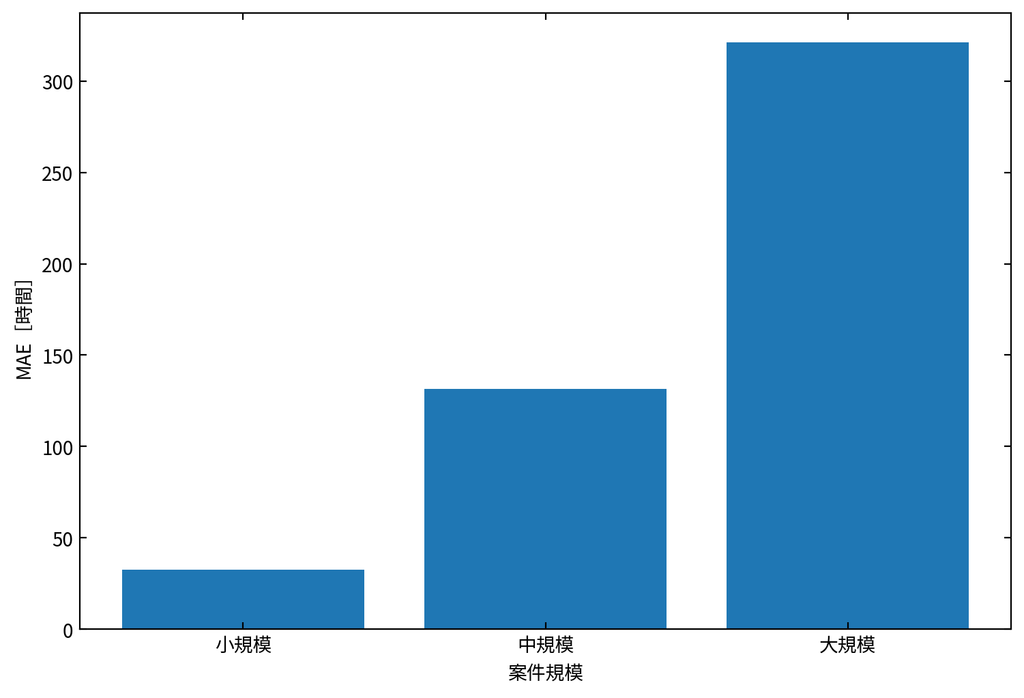
今回の人工データでは、小規模案件のMAEは32.6時間、中規模は131.5時間、大規模は321.2時間でした。
一方、絶対誤差率中央値は小規模10.9%、中規模14.0%、大規模12.6%です。つまり大規模案件は時間単位のMAEが大きくても、相対的なズレが同じ割合で大きいとは限りません。
MAEは元データと同じ「時間」という単位で読めるため実務上扱いやすい一方、案件規模の異なるグループを比較するときには尺度の影響を受けます。
部署×案件種別まで分解する
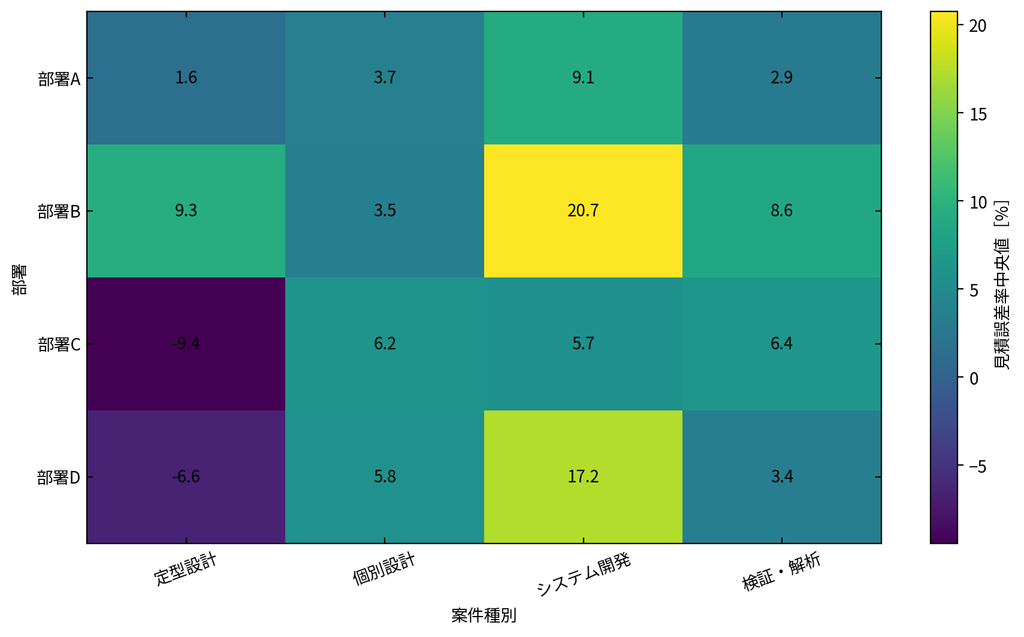
部署と案件種別を組み合わせると、部署Bのシステム開発では見積誤差率中央値が+20.7%、部署Dのシステム開発では+17.2%となりました。一方、同じ部署Dでも定型設計は−6.6%です。
この結果からも、「部署Dは見積が甘い」とまとめるより、どの部署のどの案件種別でズレが発生しているかまで分解する方が改善策を設計しやすいことが分かります。
統計的な差を確認するときの注意
今回は参考として、部署別の見積誤差率についてKruskal-Wallis検定も実施しました。Kruskal-Wallis検定は複数群の順位情報を用いて分布差を検討するノンパラメトリックな方法です(Kruskal and Wallis, 1952)。
人工データではH=22.915、p<0.001となり、部署間の誤差率分布には統計的な差が検出されました。一方、参考として算出したε²は約0.04でした。
ここで「p<0.05だから問題部署が存在する」と結論付けてはいけません。案件数が増えれば小さな差も統計的に検出される場合があります。箱ひげ図、中央値、MAE、案件構成、実務上の差の大きさと合わせて解釈します。
見積誤差を業務改善へどう戻すか
分析結果をグラフで終わらせず、次の見積へ戻すことが重要です。
| 分析結果 | 確認・改善すること |
|---|---|
| 特定案件種別で過小見積 | 標準工数、類似案件の参照方法、レビュー項目 |
| 大型案件ほど時間誤差が拡大 | 案件規模別のレビュー基準、バッファ設定 |
| 新規案件でばらつきが大きい | 不確実性項目の記録、前提条件の明文化 |
| 特定部署で偏り | 案件構成差を確認した上で見積方法を確認 |
| 一部案件だけ極端に外れる | 入力ミスか実際の手戻り・仕様変更かを個別確認 |
案件ID、見積工数、実績工数、部署、案件種別などがExcelや工数管理システムに残っていれば、予測モデルを構築しなくても、まず見積誤差が大きくなる条件を整理できます。
担当者ランキングには使わない
部署別・担当者別に集計できるデータがあっても、分析結果をそのまま個人の見積能力ランキングへ使用することには注意が必要です。
難易度の高い案件、新規顧客、大型案件を多く担当する人ほど誤差が大きくなる可能性があります。また、部署によって会議工数・管理工数・外注工数を実績へ含めるルールが異なれば、そもそも比較可能なデータではありません。
まず「誰が外したか」ではなく、「どのような案件条件で見積が外れやすいか」を確認する方が、組織としての改善につながりやすくなります。
まず既存Excel・CSVから始める
- 完了案件だけを対象にする
- 案件IDで見積工数と実績工数を紐付ける
- 部署間で工数の集計範囲を統一する
- 誤差・絶対誤差・誤差率を計算する
- 全体MAEと誤差中央値を確認する
- 部署別に箱ひげ図を作る
- 案件種別・規模・難易度で層別する
- 外れ値は削除せず内容を確認する
- 見積が外れやすい条件を見積レビューへ反映する
- 改善後も同じ指標で継続評価する
まとめ
見積工数と実績工数の差を改善するために、最初から高度なAIモデルを構築する必要はありません。
今回の500件の人工例では、全体MAE149.0時間という結果だけでなく、部署Bでは過小見積傾向、部署Cでは誤差率のばらつき、部署Dでは大型案件構成による時間単位MAEの増大という異なる特徴が確認できました。
さらに案件種別まで分けると、システム開発で過小見積傾向が強いことも確認できました。このように、全社平均から部署、案件種別、案件規模へ順に分解することで、見積ルールやレビュー方法を見直すための具体的な論点を整理できます。
SCI総合研究所株式会社のRASHINRAでは、顧客・案件・売上・原価・工数等のデータを、単なる集計ではなく経営・業務上の判断につながる形へ整理します。見積と実績の差が大きい場合も、現在保有しているExcel・CSVや工数管理データから、分析可能な範囲を整理できます。
見積・実績・案件属性を確認しながら、どの条件で工数がずれやすいか、追加で記録すべき情報は何か、どの案件を重点的にレビューすべきかを検討します。
参考文献
- 角田雅照 et al. 2025. ソフトウェア工数見積もりにおける規模計測方法の影響抑制. コンピュータ ソフトウェア. Vol. 42. Issue 4. pp. 4_55-4_61. https://doi.org/10.11309/jssst.42.4_55
- Hyndman, R. J. and Koehler, A. B. 2006. Another look at measures of forecast accuracy. International Journal of Forecasting. Vol. 22. Issue 4. pp. 679-688. https://doi.org/10.1016/j.ijforecast.2006.03.001
- Kruskal, W. H. and Wallis, W. A. 1952. Use of Ranks in One-Criterion Variance Analysis. Journal of the American Statistical Association. Vol. 47. Issue 260. pp. 583-621. https://doi.org/10.1080/01621459.1952.10483441