
SIerや受託開発、個別受注型の製造業では、受注時点では十分な利益が出ると想定していた案件が、完了時には赤字になっていることがあります。
背景には、見積工数と実績工数のずれ、追加外注、短納期、要件の曖昧さ、技術的不確実性など複数の要素があります。しかし、案件終了後に「この案件は採算が悪かった」と確認するだけでは、次の受注判断へ十分に知見を戻せません。
そこで考えたいのが、過去の完了案件から、受注・着手前に重点的に見直すべき案件を絞り込む方法です。
本記事では500件の人工完了案件を作成し、見積金額、見積工数、見積粗利率、工期、予定人数、外注予定比率、要件明確度など、受注時点で得られる情報だけを使って赤字/黒字を分類します。
なお、記事中の案件金額、工数、粗利、モデル性能はすべて説明用の人工データです。実際の企業・案件の実績を示すものではありません。
「受注時は利益が出るはずだった案件」が赤字になる
見積時点では、予定売上から予定工数・外注費などを差し引き、一定の粗利を確保できる前提で受注判断を行います。
しかし実際には、要件追加、想定外の技術課題、手戻り、体制変更などにより工数や原価が増えることがあります。ソフトウェア開発の工数見積についても、機械学習を含む多数の手法が研究されていますが、案件やデータの条件によって適した方法が異なることが報告されています(Wen et al., 2012)。
今回扱うのは工数そのものの予測ではなく、最終的な案件採算が赤字になるリスクです。
赤字案件を予測する前に「赤字」を定義する
モデルを作る前に必要なのが、何を赤字案件とするかの定義です。
今回は説明用として、売上高から実績直接原価を差し引いた「実績粗利益」が0円未満になった案件を赤字と定義しました。
ただし実務では、社内人件費、外注費、クラウド・ライセンス費、旅費、購入部材など、どこまでを案件直接原価へ含めるかが企業によって異なります。
赤字予測を始める前に、自社の管理会計上の案件採算定義を統一することが前提になります。
今回のケーススタディ:500件の人工完了案件
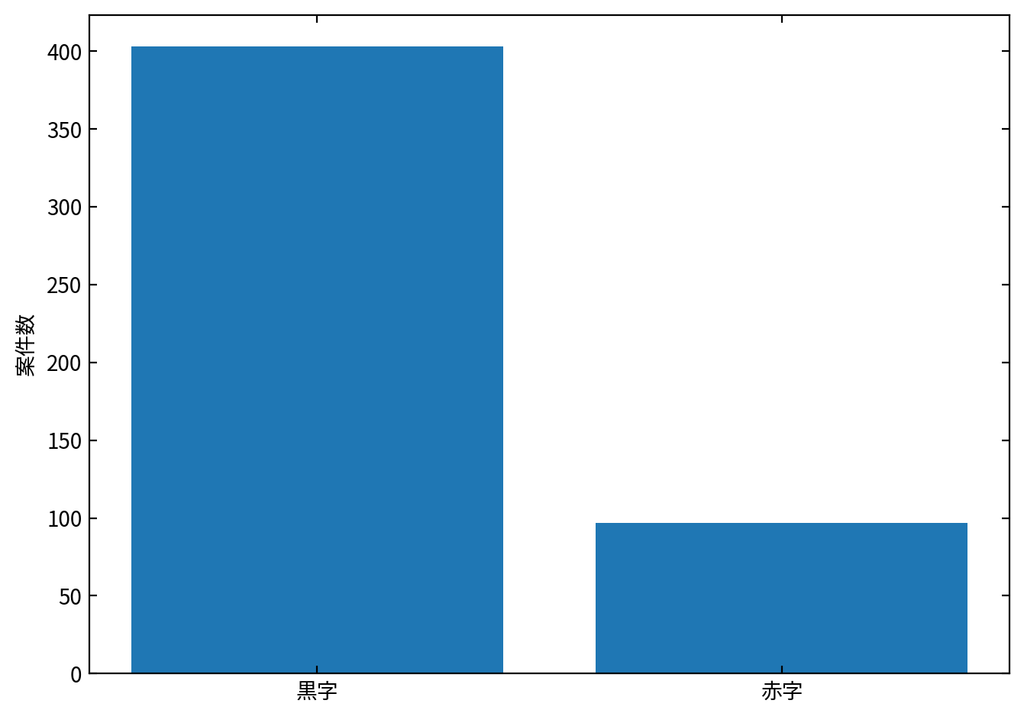
今回は500件の人工完了案件を生成しました。すべての案件について、見積段階では10~46%の範囲で正の粗利率を想定しています。
一方、人工的な工数・原価変動を加えた結果、97件、全体の19.4%が実績粗利益0円未満の赤字案件となりました。
モデルの入力には見積金額、見積工数、見積原価、見積粗利率、予定工期、予定人数、外注予定比率、要件明確度、技術的新規性、過去取引件数、案件種別、契約形態などを使用します。
実績工数、実績原価、実績粗利益など、案件完了後にしか分からない情報はモデル入力へ使用しません。
見積粗利率だけでは赤字案件を分け切れない
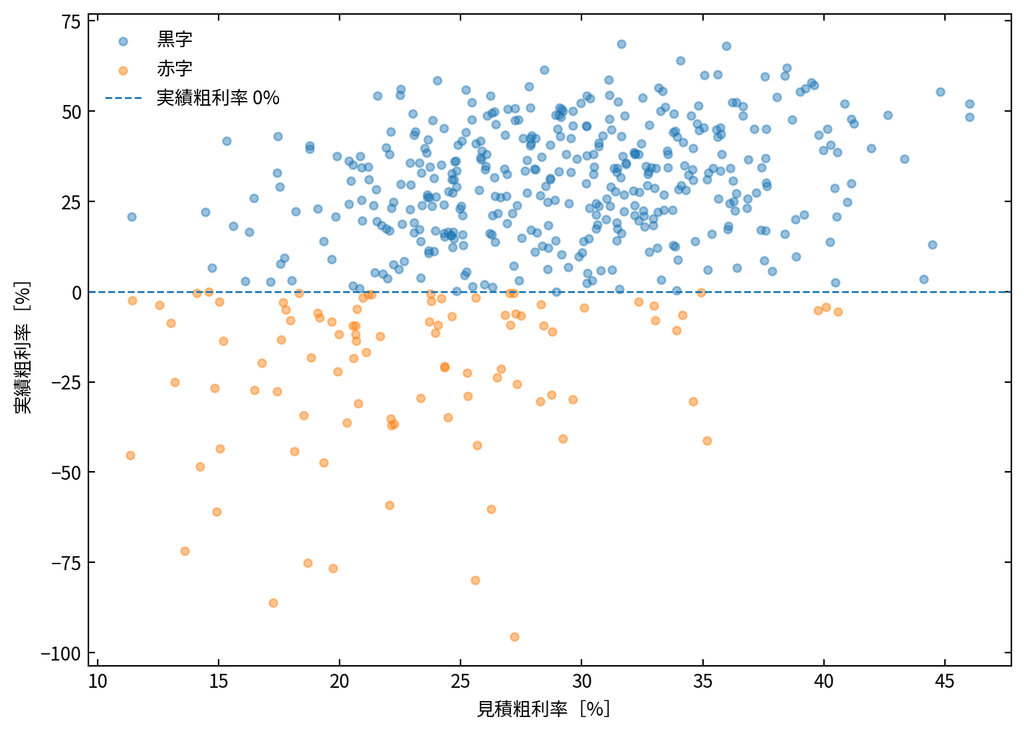
人工データでは、見積粗利率が低い案件ほど赤字化リスクが高くなる構造を含めています。しかし、同じ見積粗利率帯でも黒字案件と赤字案件が混在します。
その理由は、採算が見積粗利率だけで決まるわけではなく、案件の不確実性や工数超過など複数条件の影響を受けるためです。
工数超過と赤字は同じではない
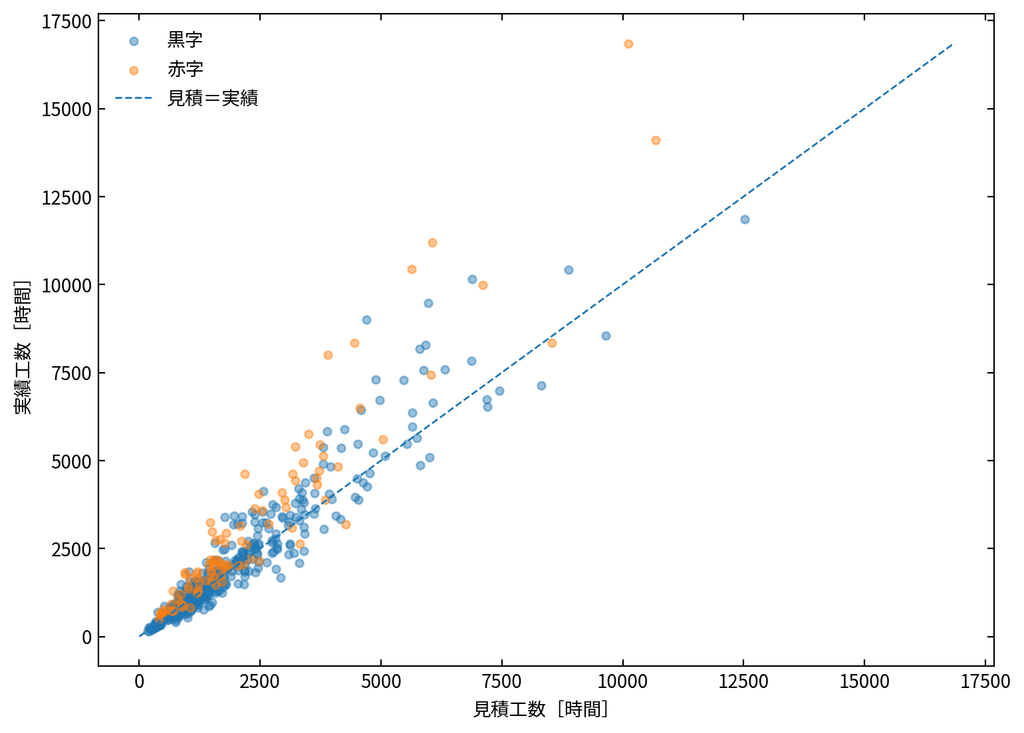
赤字案件では実績工数が見積工数を上回るケースが見られますが、工数超過した案件がすべて赤字になるわけではありません。
十分な粗利を確保していれば工数が増えても黒字を維持できる場合があります。逆に、見積段階の利益余力が小さければ比較的小さな原価超過でも赤字化する可能性があります。
したがって、今回の目的変数は「工数超過したか」ではなく、最終的な案件採算が赤字になったかとしています。
Random Forestで赤字/黒字を分類する
分類モデルにはRandom Forestを使用しました。Random Forestは、異なるデータ・特徴量を使って作成した多数の決定木を組み合わせて分類・回帰を行うアンサンブル手法です(Breiman, 2001)。
将来案件への利用を想定し、見積日の古い順に300件を学習、100件を検証・確率校正、最後の100件を最終評価へ分けました。
評価100件のうち24件が赤字案件でした。
Accuracyだけでは赤字予測を評価できない
今回の人工データでは赤字案件が全体の約2割です。このようなデータでは、黒字と予測するだけでもAccuracyが高く見える可能性があります。
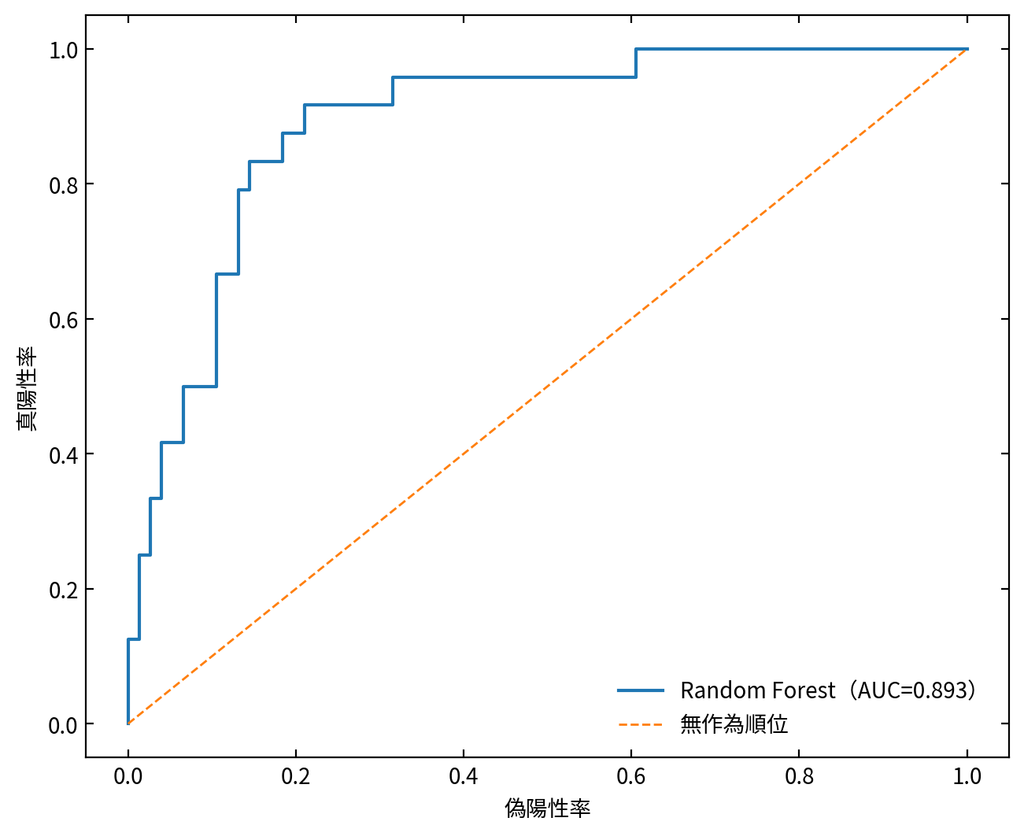
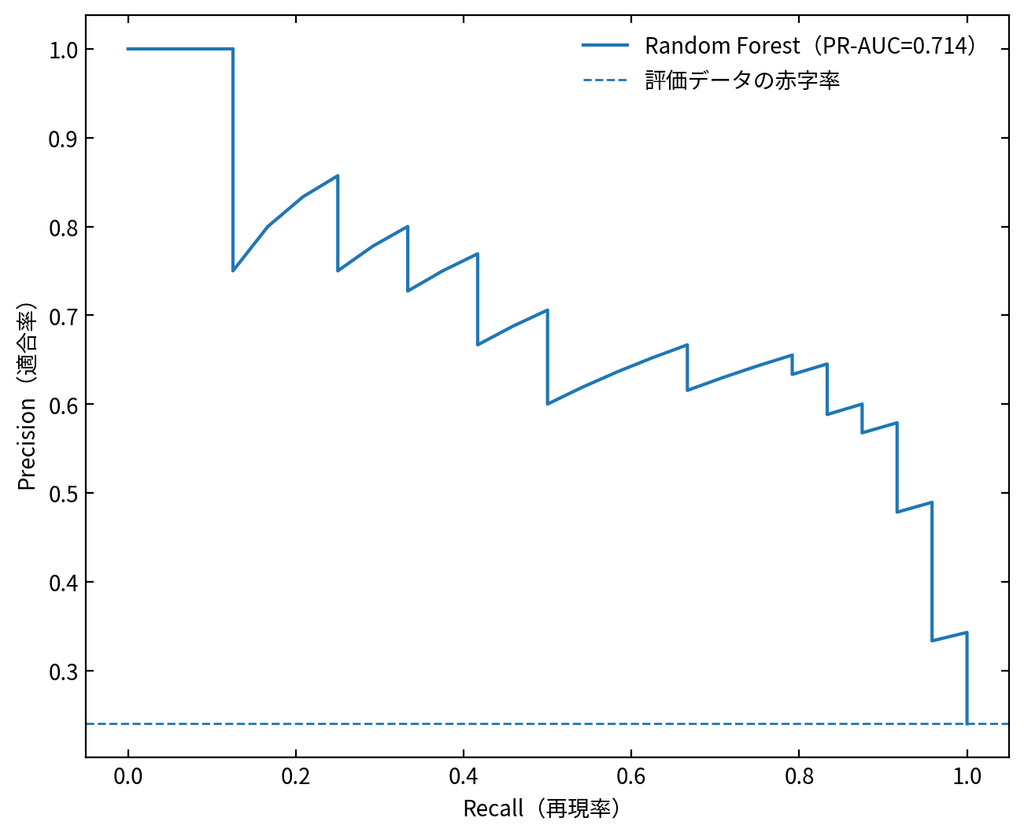
そこで、ROC-AUCに加え、赤字案件のような少数クラスの評価で重要になるPR-AUC、Precision、Recall、F1を確認しました。
| 評価指標 | 人工評価データでの結果 |
|---|---|
| ROC-AUC | 0.893 |
| PR-AUC | 0.714 |
| Accuracy | 0.800 |
| Precision | 0.550 |
| Recall | 0.917 |
| F1 | 0.688 |
今回は「赤字案件を見逃さず、受注前の追加レビューへ回す」用途を想定し、検証データでRecallを高める方向に説明用の判定閾値を設定しました。
赤字案件の見逃しをRecallで確認する
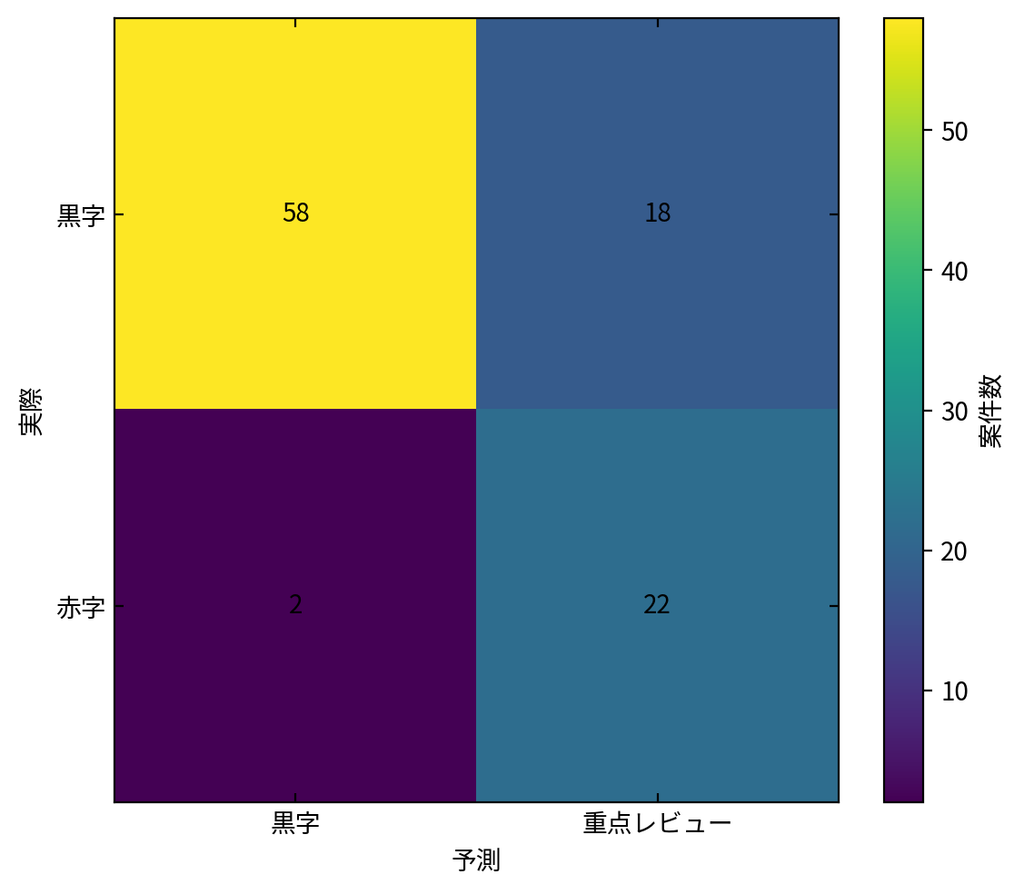
評価100件では、24件の赤字案件のうち22件を重点レビュー候補として抽出し、2件を見逃しました。一方、黒字76件のうち18件も重点レビュー候補となっています。
つまり、この設定では赤字案件の見逃しを抑えられる一方、実際には黒字となる案件も追加レビュー対象になります。
受注審査の補助として使う場合は、見逃しコストとレビュー工数のどちらを重視するかによって判定条件を変える必要があります。
モデル出力を「赤字確率」として使う場合の注意
分類モデルの出力スコアが0.7であっても、それだけで「この案件は70%の確率で赤字になる」と解釈できるとは限りません。
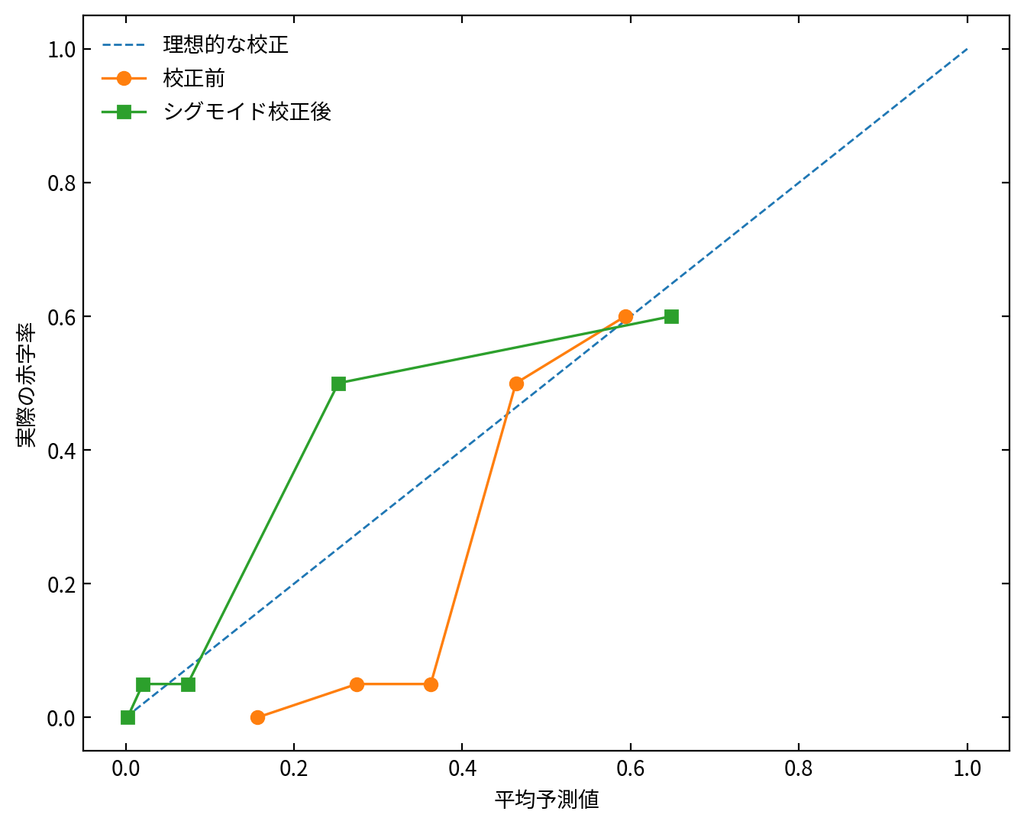
確率値として利用する場合は、予測値と実際の発生率が対応しているかを確認する確率校正が必要です。分類精度やAUCが良好でも、確率値自体が適切とは限らないことが知られています(Niculescu-Mizil and Caruana, 2005)。
今回の人工データではBrier Scoreが校正前0.145から校正後0.115へ低下しました。ただし、校正後の数値も将来案件で継続的に検証する必要があります。
Permutation Importanceでモデルが見た条件を確認する
モデルがどの入力情報を利用していたかを確認するため、今回はPermutation Importanceを使用しました。
Permutation Importanceは、ある特徴量だけをランダムに入れ替えたときにモデル性能がどの程度低下するかを見る方法です。今回の記事ではPR-AUCの低下量を重要度として確認しています。
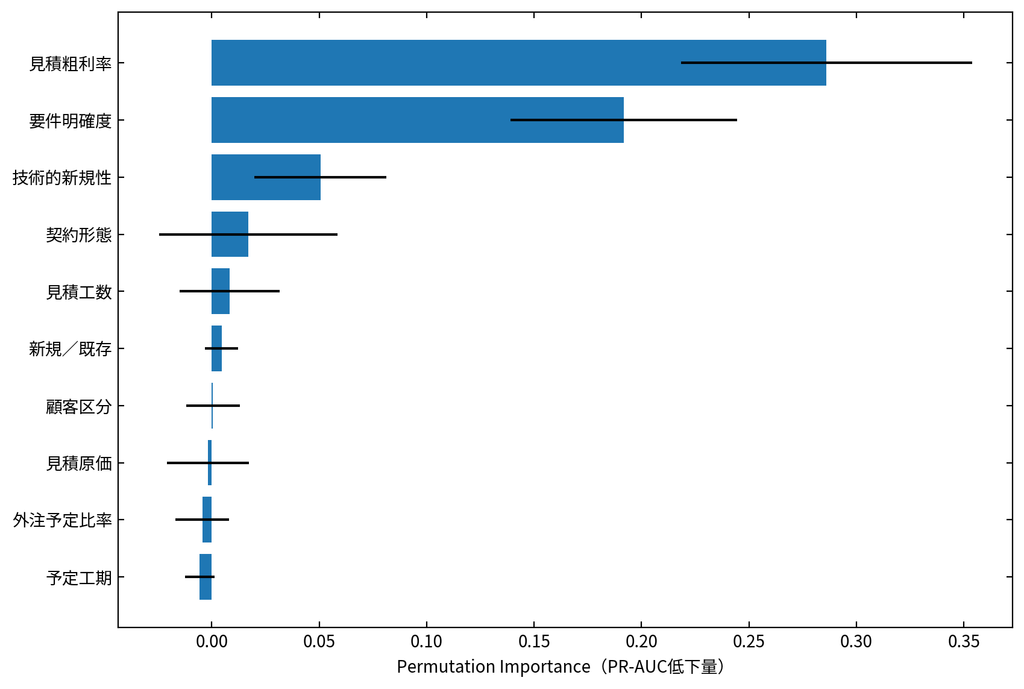
今回の人工データでは、見積粗利率、要件明確度、技術的新規性が上位となりました。Random Forestの変数重要度にはデータ型や変数構造による偏りが生じ得ることも報告されており、重要度の解釈には注意が必要です(Strobl et al., 2007)。
特徴量重要度は赤字原因を証明しない
例えば要件明確度の重要度が高くても、「要件を1段階明確にすれば赤字率が何%下がる」と結論付けることはできません。
要件が曖昧な案件ほど新規性が高い、請負契約が多い、短納期であるなど、別の条件が同時に存在する可能性があります。
特徴量重要度は、モデルが赤字/黒字を分類するときにどの情報を利用したかを確認し、その後の案件レビューで確認すべき観点を整理するために使います。
赤字リスク×案件金額で重点レビュー候補を見る
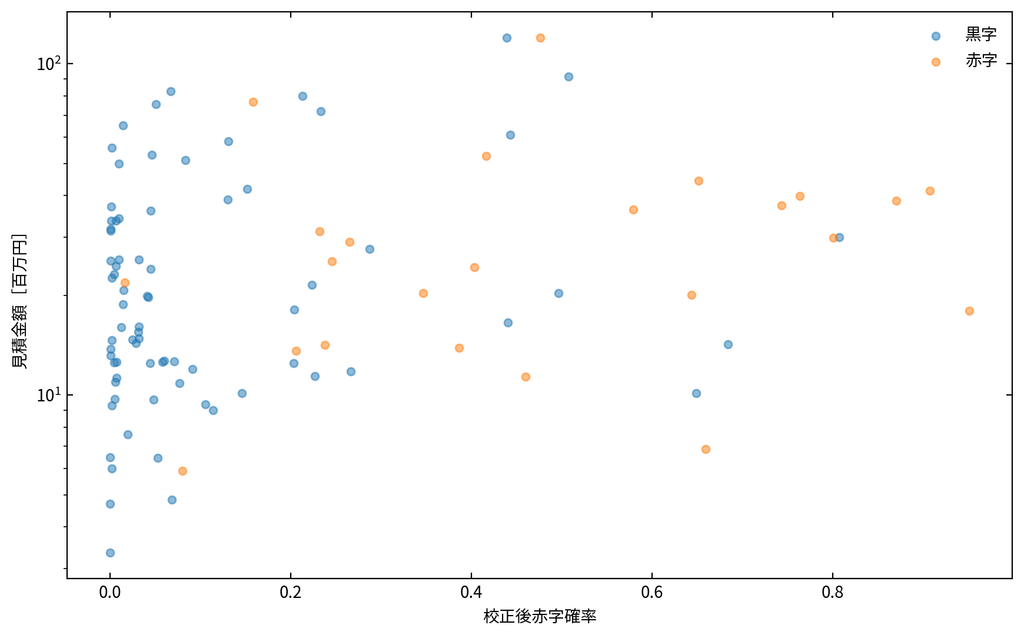
評価100件を赤字リスク順に並べたところ、上位20件では12件が実際の赤字案件となり、上位20%の実赤字率は60%でした。また、評価期間に存在する赤字24件のうち12件、50%がこの上位20件に含まれました。
大型かつ高リスクの案件は、限られた受注審査時間の中で優先的に確認する候補になり得ます。
ただし、図の右上にある案件を「受注してはいけない案件」と判断するものではありません。リスクの大きさに応じて追加レビューの優先度を変えるための情報です。
高リスク案件が出たら何を再確認するか
表1 受注前に利用できる主な案件データ
| 分類 | 例 |
|---|---|
| 見積 | 見積金額、見積工数、見積原価、見積粗利率 |
| スケジュール | 予定工期、開始予定日 |
| 体制 | 予定人数、外注予定比率 |
| 案件属性 | 案件種別、規模、技術的新規性 |
| 契約 | 請負、準委任等 |
| 顧客 | 新規/既存、過去取引件数 |
| 不確実性 | 要件明確度等 |
表2 高リスク案件で再確認したい事項
| 確認観点 | 確認内容 |
|---|---|
| スコープ | 成果物・対応範囲・対象外が明確か |
| 見積前提 | 前提条件が見積書・提案書に記載されているか |
| 変更管理 | 要件変更時の再見積・追加費用条件があるか |
| 工数余力 | 不確実性に対するバッファが妥当か |
| 体制 | PM・技術者・外注体制を確保できるか |
| 契約 | 案件特性に対して契約方式が適切か |
| 納期 | 過度に短いスケジュールとなっていないか |
| レビュー | PMO・経営層による追加審査が必要か |
案件IDを軸に、見積金額・見積工数・実績工数・原価・売上を紐付けられる場合は、機械学習モデルを構築する前でも、赤字案件に共通する条件や見積・実績差異を整理できます。
500案件あっても十分とは限らない
今回の記事では500案件を用いましたが、500件あればどの企業でも十分という意味ではありません。
総案件数だけでなく、赤字案件数、入力項目数、案件種別のばらつき、同一顧客案件の偏り、欠損、契約条件の変化などによってモデルの安定性は変わります。
データが少ない場合は、まず案件種別別の粗利率、見積・実績工数比、契約形態別の赤字率といった基礎集計から始める方が適切なこともあります。
まず完了案件の見積・実績差異から始める
- 案件ごとの赤字定義を決める
- 完了案件について見積・売上・原価・工数を案件IDで紐付ける
- 見積工数と実績工数の差を確認する
- 案件属性別の赤字率を集計する
- 受注時点で取得できていた項目を整理する
- 未来情報が混入していないか確認する
- 過去案件から将来案件の順にデータを分ける
- 赤字案件をどの程度拾えるか確認する
- 高リスク案件で確認すべき項目を決める
- 実案件でレビュー結果と最終採算を継続評価する
まとめ
赤字案件分析の目的は、AIに受注判断を任せることではありません。完了案件の見積・実績データを次の受注判断へ戻し、見直すべき案件を早い段階で把握することです。
今回の500件の人工例では、全体の19.4%が赤字案件となり、受注前情報だけを使ったRandom ForestでROC-AUC 0.893、PR-AUC 0.714となりました。赤字案件の見逃しを抑える説明用設定では、評価24件の赤字案件のうち22件を重点レビュー候補として抽出しました。
一方、18件の黒字案件も重点レビュー候補となっています。モデルだけで受注可否を決めるのではなく、見積前提、契約条件、スコープ、工数余力、PM体制等を再確認するための材料として使う必要があります。
SCI総合研究所株式会社のRASHINRAでは、「案件終了後に赤字が判明する」「見積工数と実績工数の差が大きい」「案件別の売上・原価・工数を意思決定へ使えていない」といった段階から、既存データで何を確認できるか整理できます。
見積・案件・売上・原価・工数データを確認しながら、見積・実績差異、案件別収益性、赤字化しやすい条件、受注前に重点レビューすべき案件などを、経営・案件判断に利用できる形へ整理します。
参考文献
- Wen et al. 2012. Systematic literature review of machine learning based software development effort estimation models. Information and Software Technology. Vol. 54. Issue 1. pp. 41-59. https://doi.org/10.1016/j.infsof.2011.09.002
- Breiman, L. 2001. Random Forests. Machine Learning. Vol. 45. pp. 5-32. https://doi.org/10.1023/A:1010933404324
- Strobl et al. 2007. Bias in random forest variable importance measures: Illustrations, sources and a solution. BMC Bioinformatics. Vol. 8. Article 25. https://doi.org/10.1186/1471-2105-8-25
- Niculescu-Mizil, A. and Caruana, R. 2005. Predicting Good Probabilities with Supervised Learning. Proceedings of the 22nd International Conference on Machine Learning. pp. 625-632. https://doi.org/10.1145/1102351.1102430