
営業案件が増えると、すべての案件を営業部長やマネージャーが同じ密度でレビューすることは難しくなります。その結果、「この案件は確度A」「この顧客は感触がよい」といった担当者の経験や感覚をもとに優先順位を決める場面もあります。
営業担当者の経験は重要ですが、担当者ごとに判断基準が異なれば、組織全体として案件を比較しにくくなります。一方、SFA・CRMやExcelに過去の案件情報と受注・失注結果が残っていれば、過去案件から受注傾向を定量化できる可能性があります。
重要なのは、AIに営業判断を任せることではなく、営業マネージャーが確認すべき案件をデータから絞り込むことです。
本記事では、1,000件の人工営業案件を作成し、LightGBMによる受注・失注分類、ROC-AUCによる順位付け性能の評価、確率校正、SHAPによるモデル説明までを実施します。
記事中の案件、金額、受注結果、モデル性能はすべて説明用の人工データです。実際の営業組織の受注率や成果を示すものではありません。
案件が増えるほど「営業担当者の感覚」だけでは優先順位を決めにくい
営業担当者が数件の商談だけを担当している場合は、案件ごとの状況を詳細に把握できます。しかし、部署全体で数十件、数百件の案件を抱えるようになると、営業会議ですべての案件を詳細に確認することは難しくなります。
そこで、案件金額、顧客区分、新規・既存、流入経路、商談経過日数、接触回数、提案提出状況などを使い、「過去の受注案件と似た条件を持つ案件」をスコア化する方法が考えられます。
ただし、受注可能性が高いことと営業上の優先順位が高いことは同じではありません。この点は記事後半で改めて整理します。
受注予測では最初に「いつ予測するか」を決める
受注予測モデルを作るとき、最初に決めるべきなのはモデルではなく「どの時点で予測するか」です。
例えば初回商談後に受注可能性を知りたいのであれば、その時点で取得できる情報だけを入力する必要があります。契約直前の営業ステージ、最終値引率、最終商談回数、失注理由などを学習へ含めれば、将来の情報を使って過去を予測するデータリークが発生します。
また、現在進行中の案件は受注でも失注でもありません。未決着案件を一律に失注として扱うと、学習ラベルそのものが不正確になります。
今回のケーススタディ:1,000件の人工商談データ
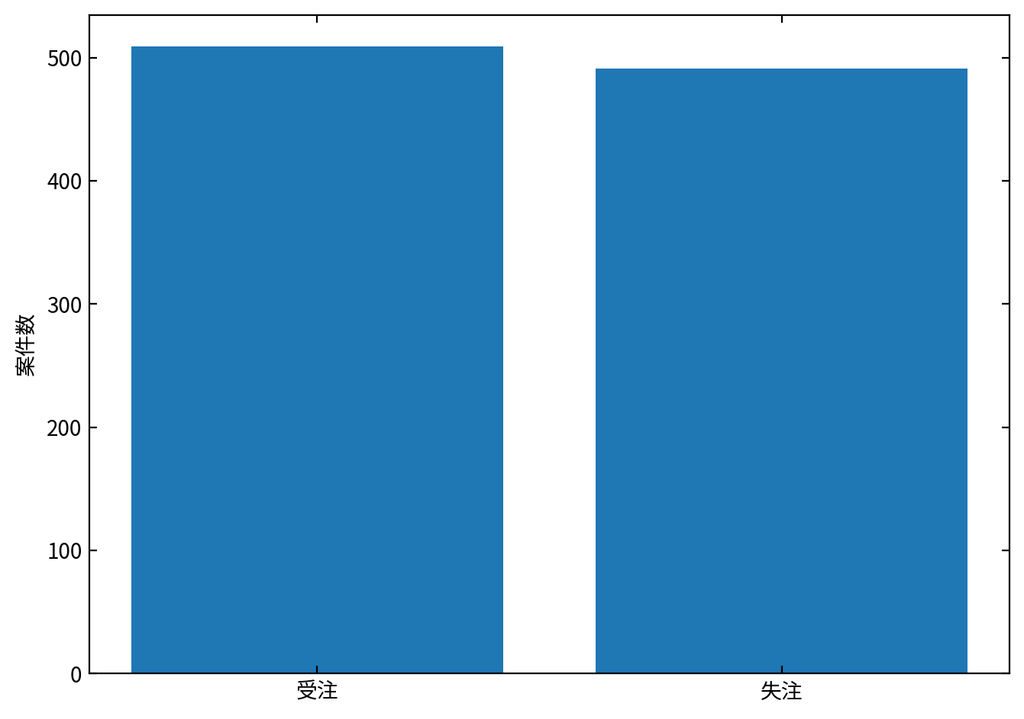
今回は受注・失注まで結果が確定した1,000件の人工営業案件を生成しました。全体では509件が受注、491件が失注です。
案件情報として、案件金額、顧客区分、新規・既存顧客、流入経路、営業ステージ、商談経過日数、接触回数、最終接触からの日数、提案提出、決裁者接点、競合把握状況、成約見込までの日数などを持たせています。
また、実際のCRMを想定し、一部項目には4~8%程度の人工欠損も付与しました。営業担当者IDも保持していますが、担当者の人事評価へ安易に利用しないため、今回のモデル入力からは除外しています。
案件金額や商談期間だけでは受注を判断できない
まず案件金額と商談経過日数を確認します。
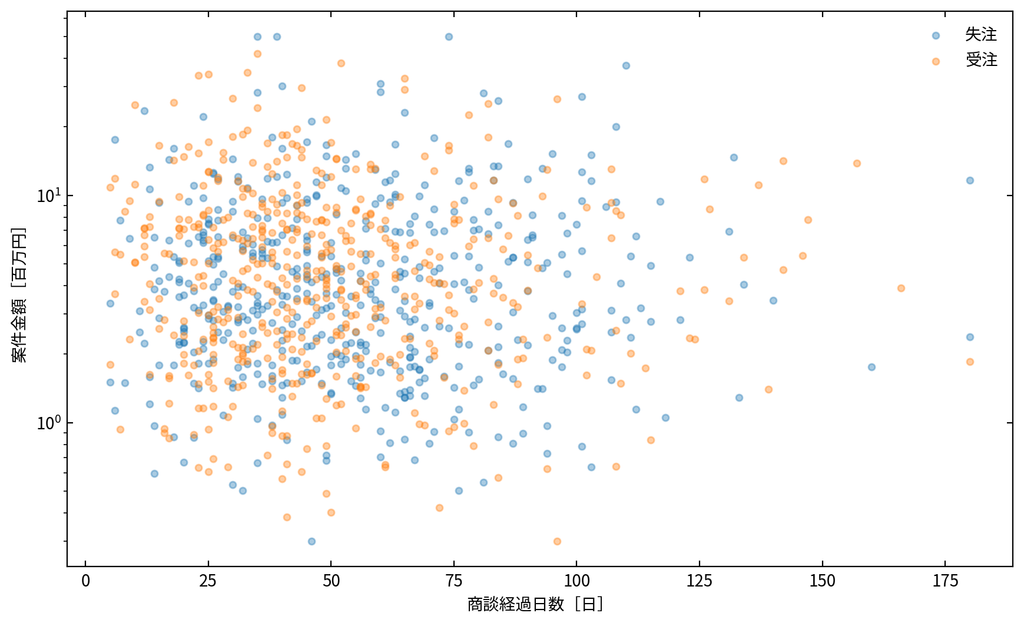
人工データでは、長期化した案件に失注が増える傾向を持たせていますが、受注案件と失注案件は大きく重なっています。案件金額についても「大型案件ほど受注しやすい」といった単純な境界はありません。
そのため、複数の案件属性と営業活動情報を同時に扱う分類モデルを使用します。
LightGBMで受注・失注を分類する
今回はLightGBMを使用しました。LightGBMは勾配ブースティング決定木を効率的に学習するために提案された手法で、GOSSやEFBと呼ばれる効率化技術が特徴です(Ke et al., 2017)。
ただし、本記事の主題はLightGBM自体ではありません。表形式の営業案件データから受注傾向を学習する分類モデルの一例として使用しています。
将来案件への適用を想定し、1~600件を学習、601~800件を確率校正、801~1,000件を最終評価へ時系列順に分けました。
最終評価200件における受注率は51.0%でした。
ROC-AUCは何を評価しているのか
モデルの順位付け性能を確認するため、ROC(Receiver Operating Characteristic)曲線とROC-AUCを使用しました。
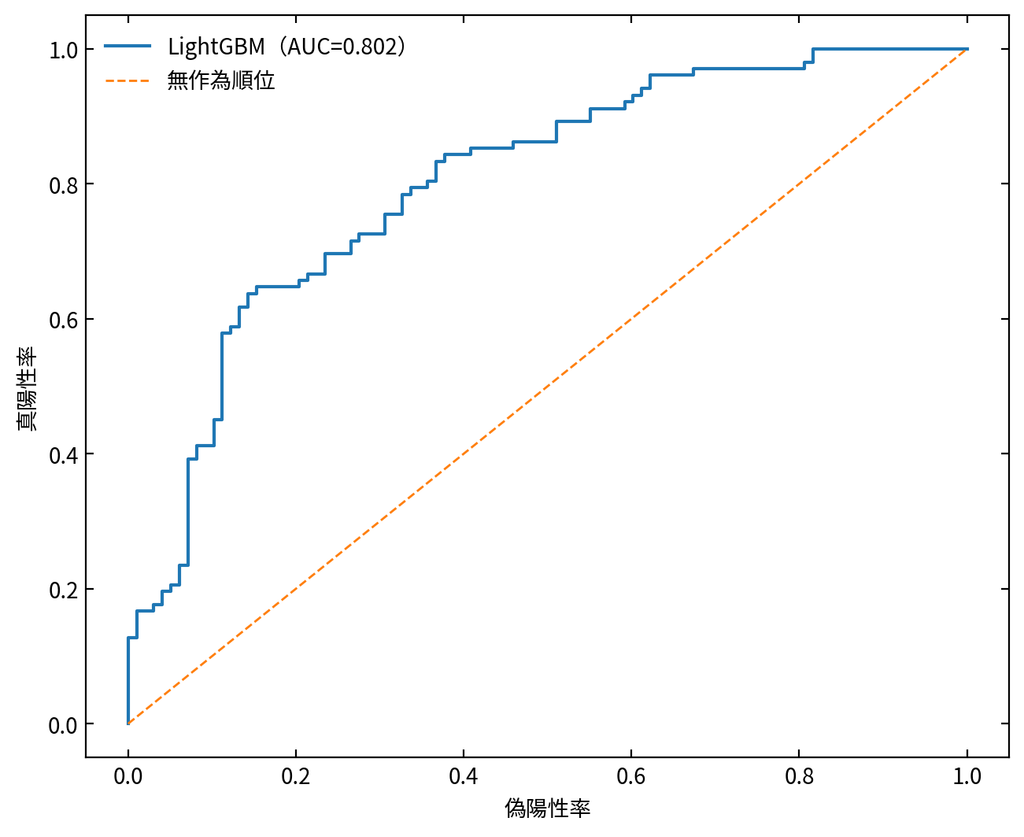
今回の人工評価データにおけるROC-AUCは0.802でした。AUCは、受注案件と失注案件をモデルスコアによってどの程度適切な順序へ並べられるかを見る指標です。
一方、AUCが0.8程度だからといって「モデルが表示した80%という値は、本当に約80%の受注率を意味する」とは言えません。ROC-AUCと確率の正しさは別の問題です。
モデルスコアと「受注確率」は同じではない
分類モデルは受注側・失注側へのスコアを出力できますが、その値を営業会議で「受注確率70%」と表示するのであれば、予測値と実際の発生頻度が対応しているかを確認する必要があります。
例えば十分に校正されたモデルで0.7付近と予測された案件群があるなら、その案件群では実際にも概ね70%程度が受注している、という関係が望まれます。
分類モデルの性能が良くても確率値そのものが良好とは限らず、確率校正を別途行う考え方が知られています(Niculescu-Mizil and Caruana, 2005)。
Calibration Curveで受注確率を確認する
今回は学習に使っていない200件の検証データを使用して、シグモイド型の確率校正を行いました。
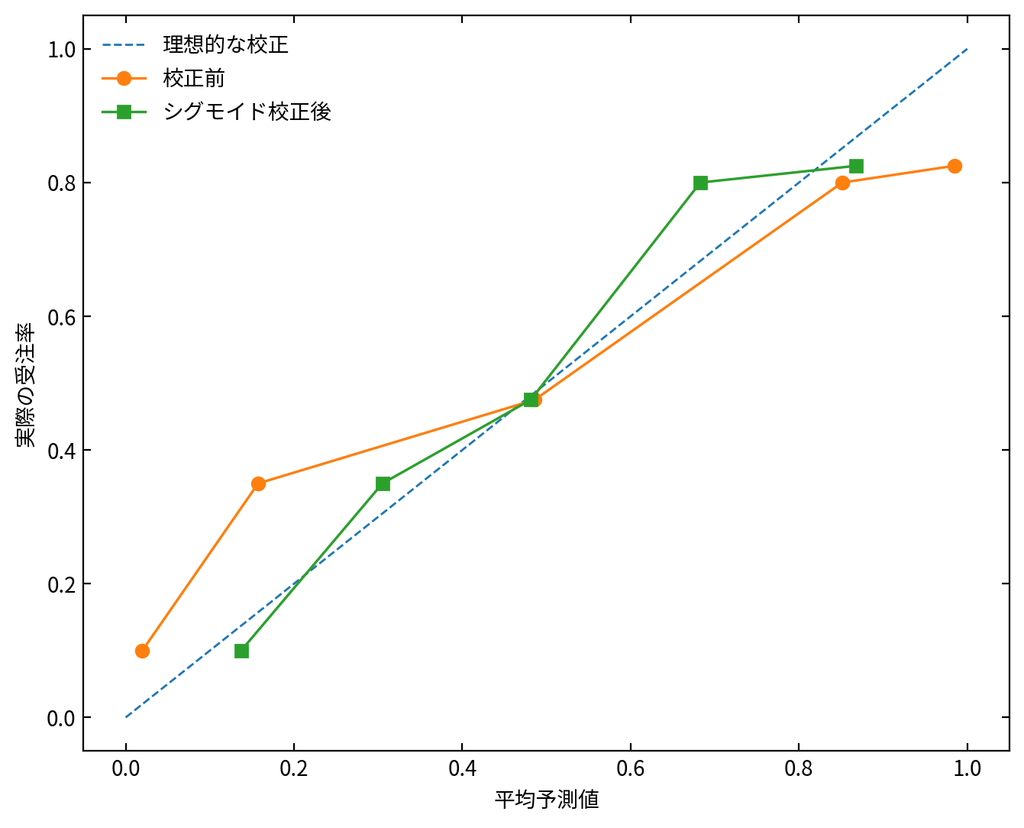
Calibration Curveでは、横軸に平均予測値、縦軸に実際の受注率を置きます。対角線に近いほど、モデルが出した数値と実際の発生頻度が対応しています。
今回の人工データでは、確率予測の二乗誤差を表すBrier Scoreが校正前0.200から校正後0.182へ低下しました。ただし、Brier Scoreには校正だけでなく分類の分離性能等も影響するため、この数値だけで確率校正の良否を断定せず、Calibration Curveと合わせて確認します。
校正後確率を0.5で区切った説明用評価では、Precision 0.740、Recall 0.696、F1 0.717でした。0.5は今回の説明用基準であり、実務では営業会議で確認できる件数や見逃しコストを考慮して設定する必要があります。
SHAPでモデルが見た案件情報を確認する
予測結果を営業担当者へ提示する場合、「なぜこの案件のスコアが高いのか」という説明も必要になります。
そこで今回はSHAP(SHapley Additive exPlanations)を使用しました。SHAPは、モデルの個々の予測に対し、各特徴量がモデル出力へどの程度寄与したかを表す方法です(Lundberg and Lee, 2017)。
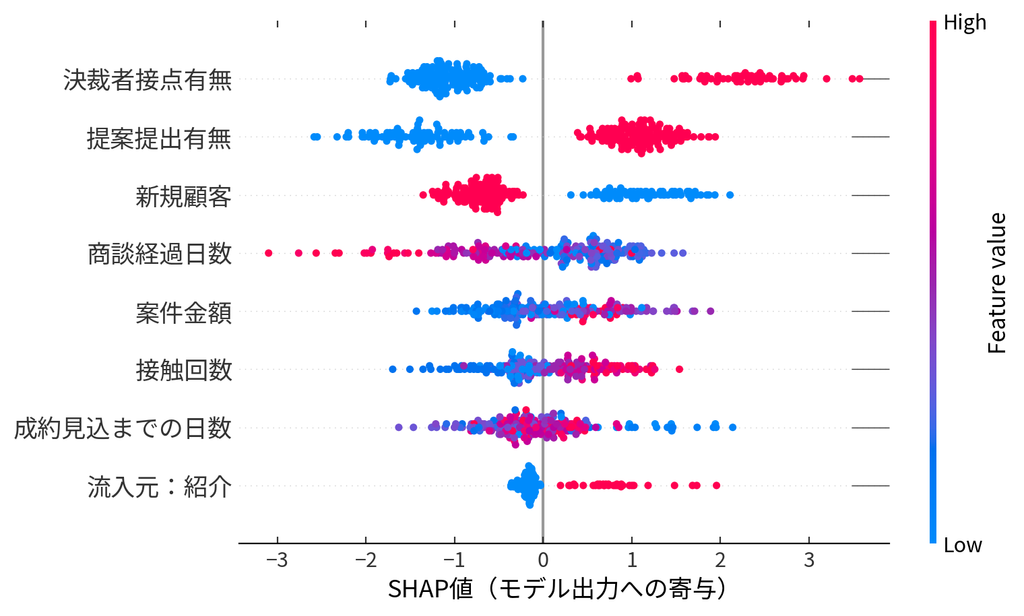
今回の人工モデルでは、平均絶対SHAP値の上位に、決裁者接点、提案提出、新規・既存区分、商談経過日数、案件金額、接触回数などが現れました。
これは今回作成した人工データとモデルにおいて、これらの情報が受注・失注の判定へ比較的大きく利用されたことを意味します。
SHAPは受注・失注原因を証明しない
例えば「決裁者との接点」が高い受注スコアと関連していても、「決裁者へ会えば受注率が上がる」という因果関係が証明されたわけではありません。
優良案件だから早い段階で決裁者へ接触できた可能性や、既存顧客案件と決裁者接点が同時に増えていた可能性もあります。
SHAPはモデルが何を使って判定したかを確認し、営業担当者が案件を再確認するための情報として扱います。営業施策そのものの効果を知りたい場合は、別途因果関係を検証する設計が必要です。
受注確率上位案件へどの程度受注案件が集まるか
営業マネージャーが200件すべてを同じ密度で確認できない場合、受注可能性の高い案件からレビューするという使い方が考えられます。
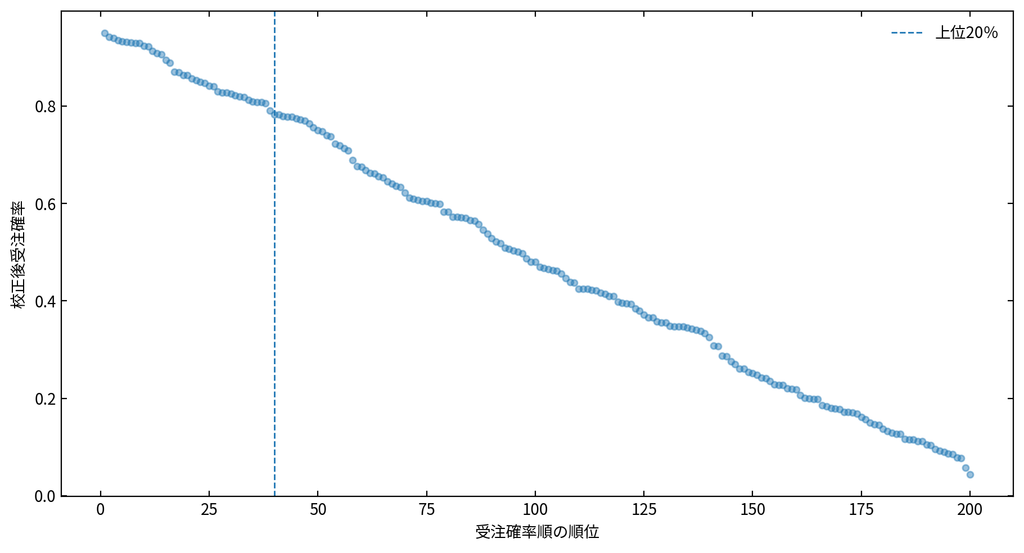
今回の人工評価データ200件では、校正後受注確率の上位20%にあたる40案件の実受注率は82.5%でした。評価200案件全体では51.0%です。
また、評価期間に存在した102件の受注案件のうち33件、約32.4%が上位40案件に含まれました。
これは「上位20%だけを追えばよい」という意味ではありません。限られた会議時間の中で、どの案件から確認するかを決める参考情報として利用できます。
受注確率だけで営業優先順位を決めない
例えば受注確率80%・案件金額100万円の案件と、受注確率45%・案件金額3,000万円の案件では、単純に確率だけを比較して営業資源を配分することはできません。
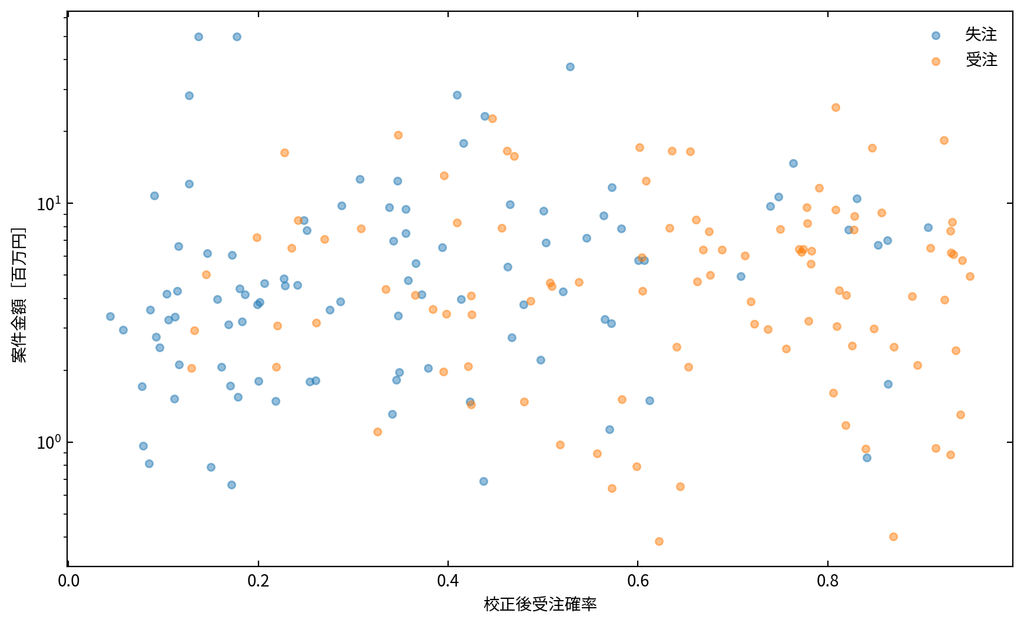
実際の営業優先順位では、受注可能性だけでなく、案件金額、粗利、必要営業工数、契約時期、顧客との中長期的関係、戦略的重要性などを合わせて判断します。
「受注確率×案件金額」で簡易的な期待売上を計算することもできますが、それも意思決定材料の一つにすぎません。利益率や営業工数を無視して、期待売上だけで案件を順位付けすることは適切とは限りません。
SFA・CRMの入力品質を先に確認する
受注予測では、モデルの種類以上に元データの品質が重要になる場合があります。
表1 モデル構築前に確認したい営業データ
| 確認項目 | 確認内容 |
|---|---|
| 案件ID | 案件を一意に識別できるか |
| 受注・失注 | 結果が確定した案件だけを正しく区別できるか |
| 未決着案件 | 失注として記録されていないか |
| 予測時点 | 各案件で同じ時点の情報を比較できるか |
| 営業ステージ | 担当者によって定義が異ならないか |
| 欠損 | 重要項目が特定担当者だけ未入力になっていないか |
| 表記 | 顧客区分・流入経路等に表記揺れがないか |
| 期間 | 営業プロセスや商材が途中で大きく変わっていないか |
| 未来情報 | 予測時点以降の情報が混入していないか |
案件ID、受注・失注結果、案件金額、顧客属性、商談履歴等がSFA・CRMやExcelに残っている場合は、いきなりAIモデルを構築する前に、まず過去案件のデータ品質と受注傾向を確認できます。
案件数が少ない場合の考え方
今回の記事では1,000案件を使用しましたが、「1,000件あれば十分」「500件では作れない」といった一律の基準はありません。
確認すべきなのは総案件数だけではなく、受注・失注件数、入力項目数、商材の種類、顧客属性の偏り、欠損率、営業プロセスの変化などです。
データが少ない場合は、複雑なモデルを作る前に、顧客区分別・案件種別・経過日数別の受注率を集計するだけでも判断材料になります。データ量に応じて分析の複雑さを上げる方が現実的です。
まず確定済み案件から分析可能性を確認する
- 受注・失注が確定した過去案件を抽出する
- 案件ID、顧客ID、結果の重複・欠損を確認する
- どの商談時点で予測するか決める
- その時点までに得られる情報だけを抽出する
- 顧客区分・商材・営業ステージ別の受注率を確認する
- 時系列で学習・検証・評価データを分ける
- 受注案件を上位へ並べられるか評価する
- 受注確率として利用するなら確率校正を確認する
- 営業会議で確認可能な案件数まで絞れるか検討する
- 受注確率以外の案件価値と合わせて意思決定する
まとめ
SFA・CRMへ過去の案件情報が蓄積されていれば、営業担当者の感覚を置き換えるのではなく、案件レビューを補助するデータとして活用できる可能性があります。
今回の1,000件の人工事例では、最終評価200件に対してROC-AUC 0.802となり、校正後受注確率上位20%の案件では実受注率82.5%となりました。
一方、AUCが一定水準にあっても、モデルスコアをそのまま受注確率として利用できるとは限りません。今回も独立した検証データによるシグモイド校正を行い、Calibration CurveとBrier Scoreを確認しました。
また、SHAPでモデルが利用した案件情報を確認できますが、それだけで受注・失注原因を証明することはできません。最終的な営業判断では、案件金額、粗利、必要工数、契約時期、戦略性なども含める必要があります。
SCI総合研究所株式会社のRASHINRAでは、「案件数が増えて全件レビューが難しい」「SFA・CRMを入力・集計だけで終わらせたくない」「過去案件から重点案件を整理したい」といった段階から、既存データで何が判断できるかを整理できます。
SFA・CRM・Excel等に蓄積された顧客・案件データを確認しながら、データ品質、分析可能性、受注傾向、重点案件の可視化、施策後の効果検証まで、営業・経営判断に必要な形へ整理します。
参考文献
- Ke et al. 2017. LightGBM: A Highly Efficient Gradient Boosting Decision Tree. Advances in Neural Information Processing Systems. Vol. 30. pp. 3146-3154. https://papers.nips.cc/paper/2017/hash/6449f44a102fde848669bdd9eb6b76fa-Abstract.html
- Niculescu-Mizil, A. and Caruana, R. 2005. Predicting Good Probabilities with Supervised Learning. Proceedings of the 22nd International Conference on Machine Learning. pp. 625-632. https://doi.org/10.1145/1102351.1102430
- Lundberg, S. M. and Lee, S.-I. 2017. A Unified Approach to Interpreting Model Predictions. Advances in Neural Information Processing Systems. Vol. 30. pp. 4765-4774. https://papers.nips.cc/paper/2017/hash/8a20a8621978632d76c43dfd28b67767-Abstract.html