
BtoB営業やSaaSでは、顧客の売上が大きく落ちた後や、契約更新直前になって初めて「離反しそうだ」と気付くことがあります。
しかし、顧客数が増えるほど、すべての顧客を同じ頻度で確認することは難しくなります。そこで考えたいのが、購買頻度、購入金額、最終取引日、問い合わせ状況など、すでに社内にあるデータから優先的に確認すべき顧客を早めに絞り込む方法です。
本記事では3,000件の人工顧客データを用い、RFM、直近の購買行動変化、問い合わせ履歴を整理し、ロジスティック回帰によって離反リスクを推定します。
記事中の顧客、取引金額、離反率、モデル性能はすべて説明用の人工データです。実在企業や実顧客の実績を示すものではありません。
売上が落ちてから顧客離反に気付いていないか
顧客離反は、必ずしも突然発生するとは限りません。発注間隔が徐々に長くなる、購入頻度が落ちる、購入金額が減る、問い合わせが未解決のまま残るなど、取引関係の変化が先に現れる場合があります。
顧客離反予測に関する研究でも、Recency、Frequency、MonetaryといったRFM情報を時間的に変化する顧客行動として扱う重要性が検討されています(Mena et al., 2024)。
ただし、予測の目的は「離反する顧客を当てる」ことだけではありません。営業・カスタマーサクセスの時間が限られている中で、どの顧客から状況を確認するかを整理することが実務上の目的になります。
顧客離反を分析する前に「離反」を定義する
最初に必要なのが離反の定義です。
SaaSなど契約型サービスでは「解約」「非更新」など比較的明確に定義できます。一方、継続購買型のBtoB取引では、90日購入がない顧客を一律に離反とみなすことはできません。年1回だけ購入する顧客も存在するためです。
実務では、顧客ごとの購買サイクルや商流を踏まえ、「一定期間取引がない」「通常の購入間隔から大幅に遅れている」「契約を更新しなかった」など、自社に適したラベルを設定します。
観測期間と予測期間を分ける
離反分析では、未来の情報をモデルへ混ぜないことも重要です。
今回は、基準日前の過去12か月を「観測期間」、その後90日を「予測期間」としました。モデル入力に使用するのは観測期間中に把握できた情報だけです。
例えば、顧客が解約した後に登録された解約理由や、離反後の問い合わせ内容を入力に含めると、実際の予測時点では利用できない未来情報を使う「データリーク」になります。
今回のケーススタディ:3,000件の人工顧客
今回は3,000件の人工顧客を作成しました。2025年1月・4月を基準日とする2,000件を学習データ、2025年7月を基準日とする1,000件を将来評価用データとしています。
全体の人工離反率は19.1%、評価用1,000件では18.9%でした。
RFMで顧客の取引状態を整理する
RFMは、Recency(最終取引からの経過期間)、Frequency(取引頻度)、Monetary(取引金額)によって顧客の取引状態を整理する方法です。
| 指標 | 意味 | 離反分析で見ること |
|---|---|---|
| Recency | 最終取引からの日数 | 通常より取引間隔が長くなっていないか |
| Frequency | 一定期間の取引回数 | 購買・利用頻度が下がっていないか |
| Monetary | 一定期間の取引金額 | 購入金額が縮小していないか |
RFMそのものの考え方は、SCI-Naviの「クラスタリングとは?業務データを使った顧客分類の考え方とPython実例」でも扱っています。
Recencyが長い顧客では何が起きているか
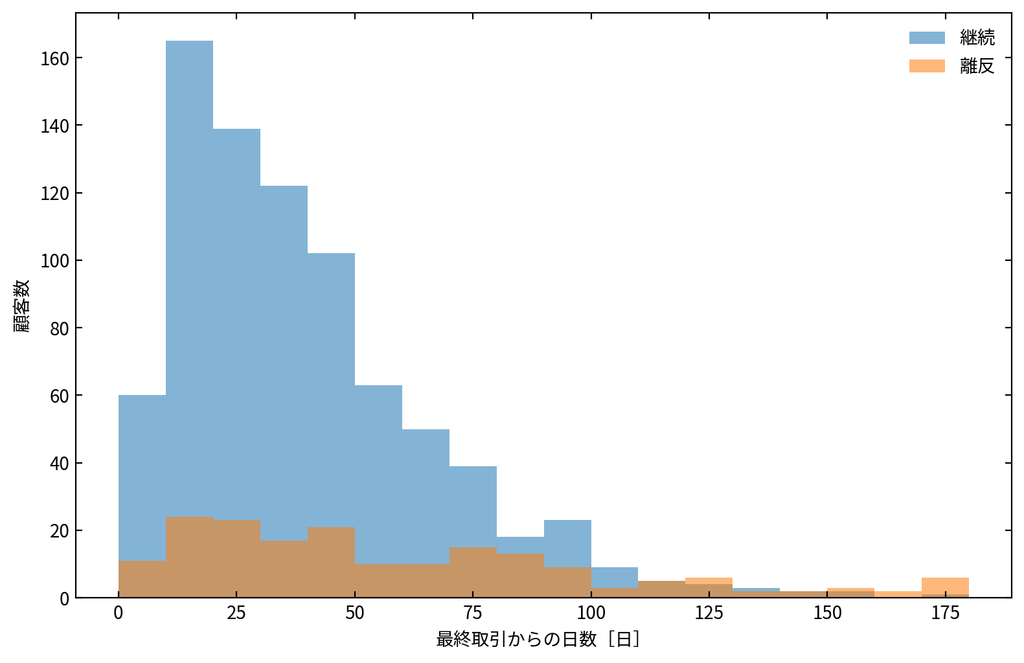
評価データでは、継続顧客のRecency中央値が34日だったのに対し、離反顧客では49日でした。Frequency中央値も継続顧客5回、離反顧客4回となりました。
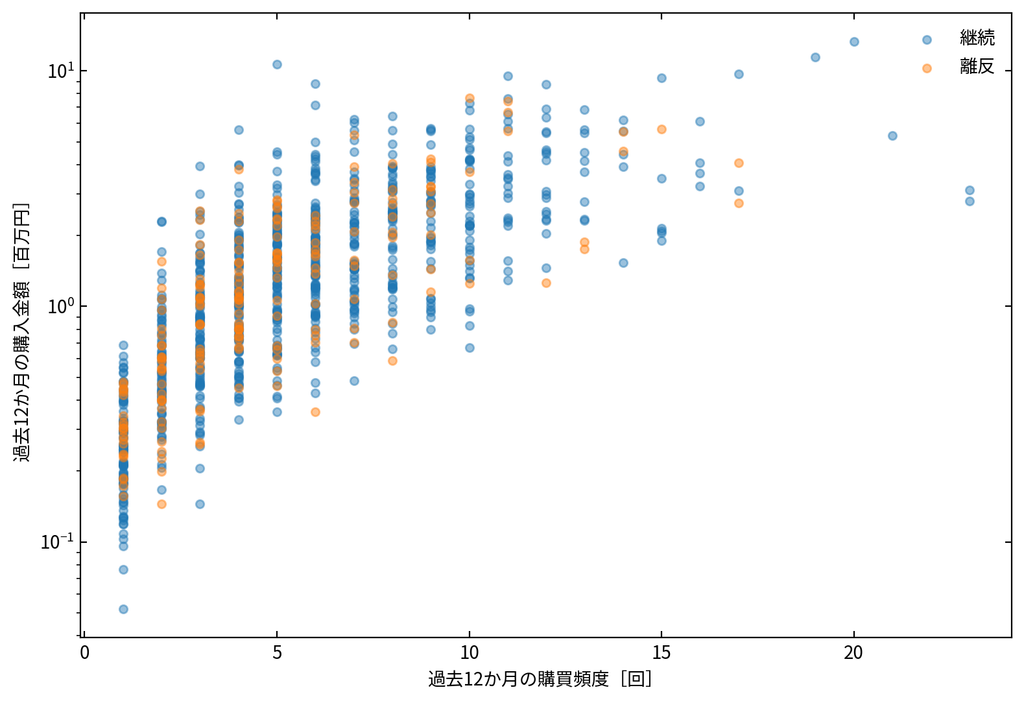
ただし、RFMの値だけできれいに離反・継続を分離できるわけではありません。同じ購入頻度・購入金額帯でも両方の顧客が存在します。
RFMだけでなく「変化量」も見る
そこで今回は、直近90日とその前90日の購買頻度・購入金額の変化も加えました。RFMを固定値ではなく時間変化として利用する考え方は、顧客離反予測の研究でも検討されています(Mena et al., 2024)。
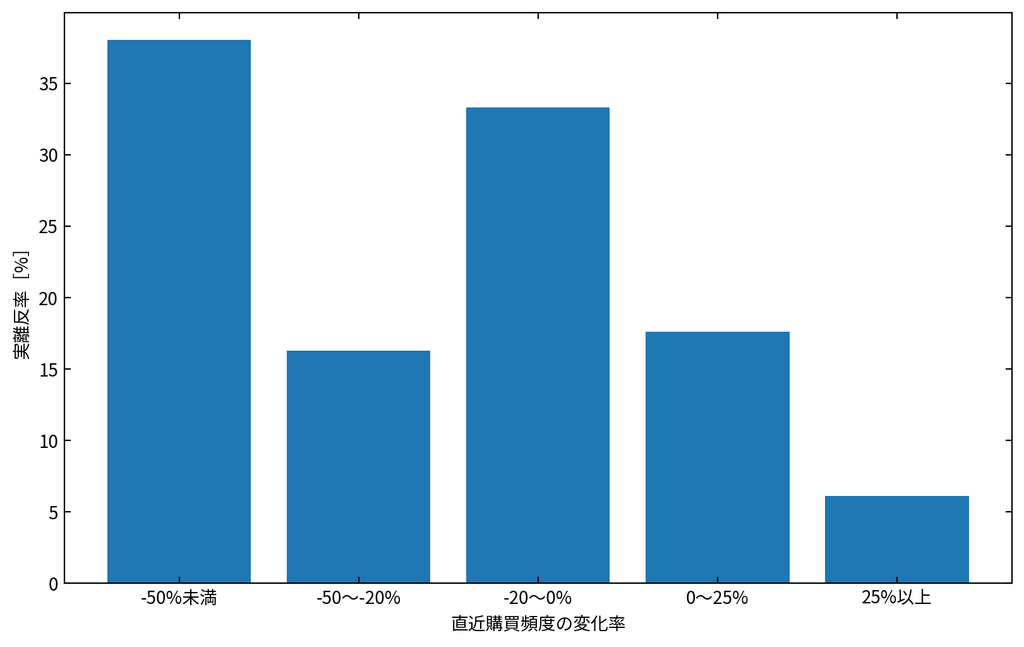
人工評価データでは、直近の購買頻度が50%以上低下した顧客群の実離反率は38.0%でした。一方、購買頻度が25%以上増えた群では6.1%でした。
これは今回の人工データに組み込んだ関係を反映した結果であり、実企業で同じ数値になるわけではありません。ただし「現在の購入回数」だけでなく、「以前からどう変わったか」を記録する考え方は実務でも重要です。
問い合わせ履歴を加える
購買データだけでは、なぜ取引が減っているか分からないことがあります。そこで今回は、直近90日の問い合わせ件数と未解決問い合わせ件数も入力しました。
ただし、「問い合わせが多い顧客ほど離反する」と単純に判断してはいけません。利用量が多い優良顧客ほど問い合わせが多いこともあります。問い合わせ内容、未解決状態、顧客規模などと合わせて解釈する必要があります。
ロジスティック回帰で離反リスクを推定する
今回は、結果が「離反/継続」の2値であるため、ロジスティック回帰を使用しました。ロジスティック回帰は、複数の説明変数と2値の結果との関係をモデル化する代表的な方法です(Hosmer et al., 2013)。
入力にはRecency、Frequency、Monetary、購買頻度変化率、購入金額変化率、問い合わせ件数、未解決問い合わせ、取引期間、新規/既存を使用しました。
標準化した係数では、今回の人工データにおいて購買頻度変化率、Recency、取引期間、未解決問い合わせが比較的大きな予測上の関連を示しました。ただし、これらは因果関係を証明する結果ではありません。
Accuracyだけで離反モデルを評価しない
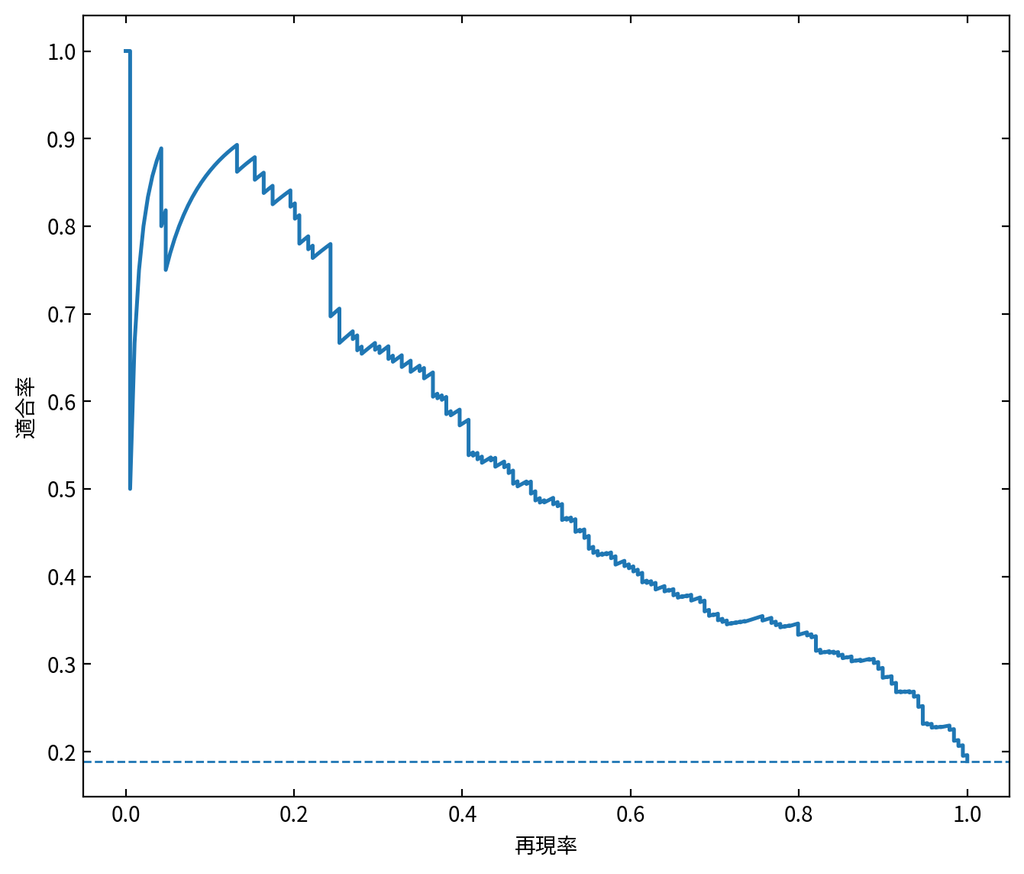
評価用1,000顧客のうち離反顧客は189件です。すべてを「継続」と予測してもAccuracyは81.1%になります。そのためAccuracyだけを見ると、離反顧客を一件も見つけられないモデルでも高性能に見える可能性があります。
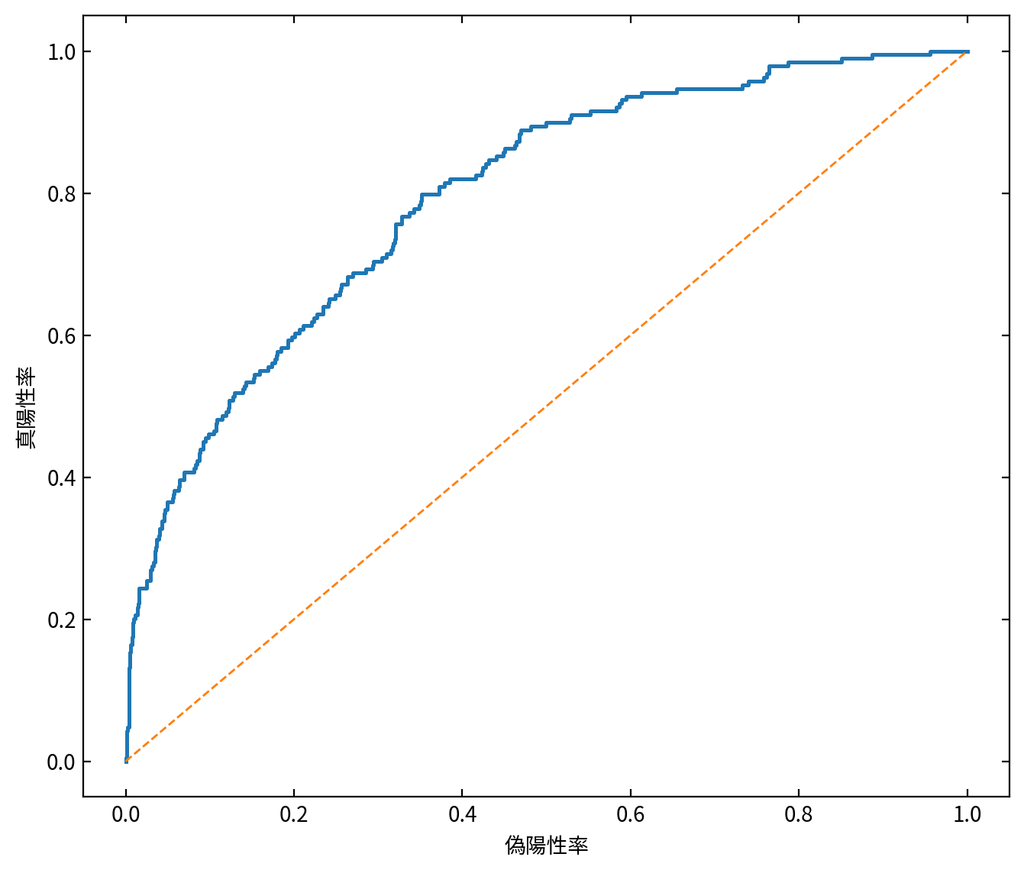
今回はROC-AUCに加え、PR-AUC、Precision、Recall、F1を確認しました。陽性クラスが少ない分類ではPrecision-Recall曲線を併用する重要性が指摘されています(Saito and Rehmsmeier, 2015)。
| 指標 | 人工評価データ |
|---|---|
| ROC-AUC | 0.795 |
| PR-AUC | 0.530 |
| Precision | 0.350 |
| Recall | 0.704 |
| F1 | 0.467 |
| Brier Score | 0.121 |
判定閾値は学習期間のF1が最大となる0.195を説明用に使用しました。その結果、実離反189件のうち133件を要確認候補として抽出し、56件を見逃しました。一方、継続顧客247件も要確認候補となっています。
つまり、単一の閾値だけで営業対象を自動決定する運用は適切ではありません。
離反確率上位20%でどこまで離反顧客を拾えるか
営業・カスタマーサクセスでは、全顧客をフォローできるとは限りません。そこで実務では「上位何%を確認すれば、実際の離反顧客をどこまで拾えるか」というTop-k評価が分かりやすくなります。
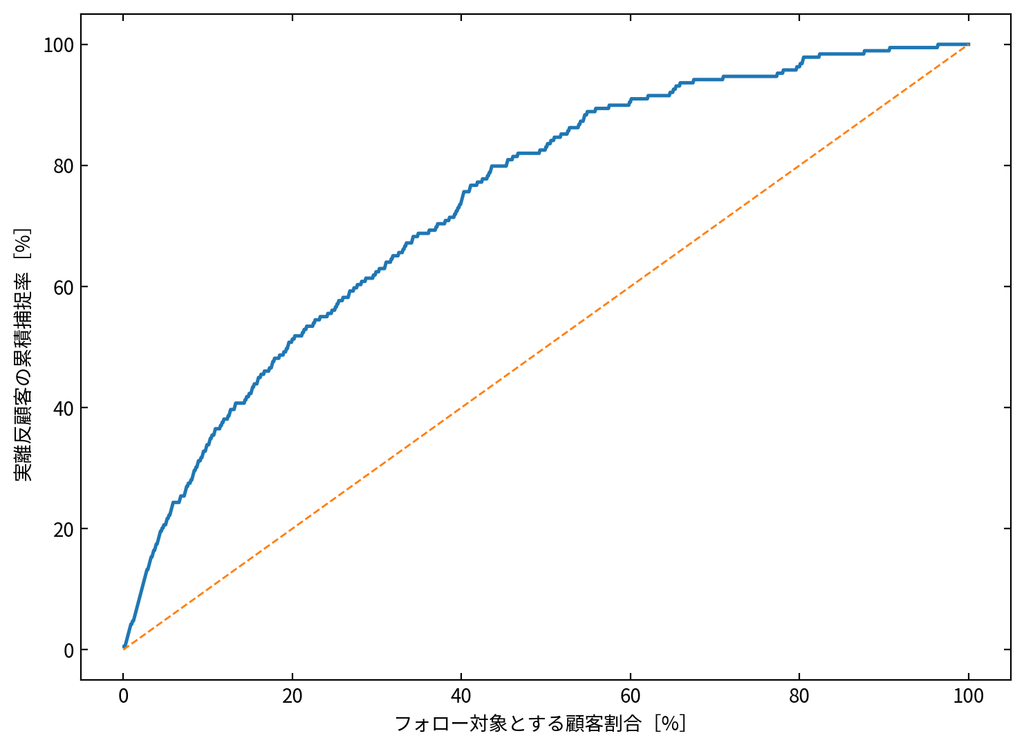
今回の人工評価データでは、離反確率上位10%、100顧客を確認すると、実離反189件のうち64件、33.9%を含みました。この100顧客の実離反率は64.0%で、評価データ全体の離反率18.9%に対するLiftは3.39倍です。
上位20%、200顧客まで広げると、97件、51.3%の実離反顧客を捕捉しました。Liftは2.57倍です。
「離反確率が19.5%を超えたら全員へ連絡する」より、営業・CSの対応可能件数から上位100社、200社などを決める方が実務へつなげやすい場合があります。
離反確率を「確定した未来」と考えない
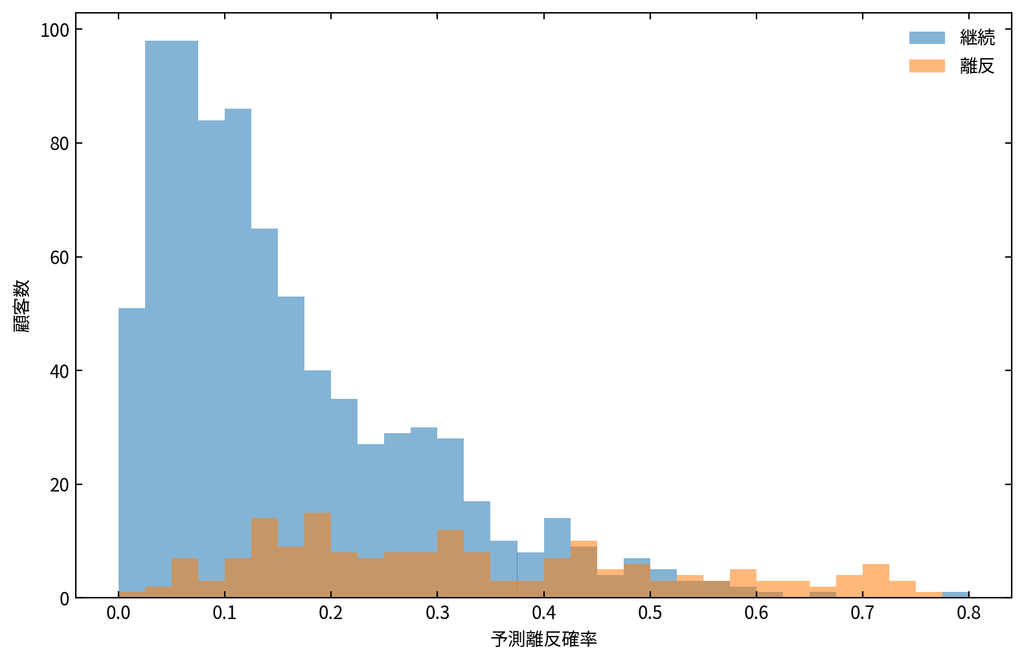
離反顧客では高い予測値が多くなっていますが、継続顧客と分布は重なっています。離反確率が高いことは、離反が確定していることを意味しません。
さらに確率値そのものを業務で利用する場合は、予測確率と実際の発生率が対応しているかを確認する必要があります。分類モデルの確率出力については、予測確率の校正を評価する重要性が知られています(Niculescu-Mizil and Caruana, 2005)。
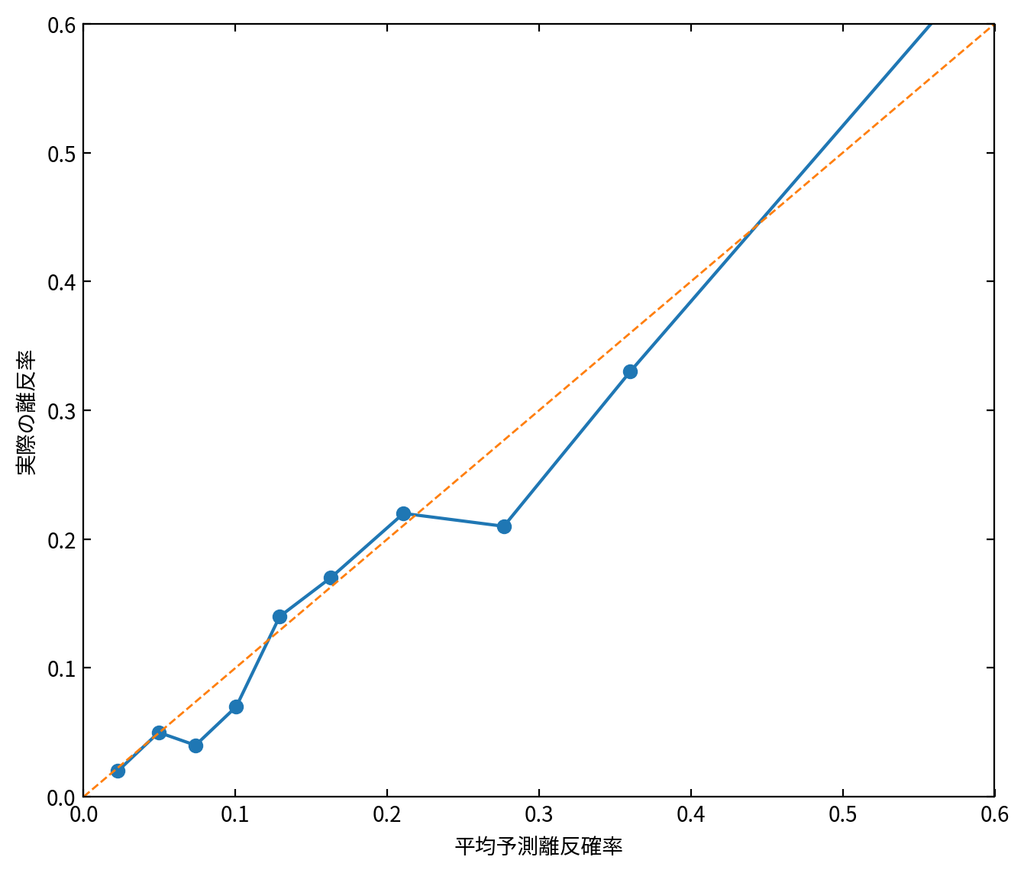
今回のBrier Scoreは0.121でした。実運用ではモデル構築時だけでなく、その後も新しい顧客データで予測確率と実離反率の関係を確認します。
高リスク顧客を見つけた後に確認すること
モデルが高リスクと判定したからといって、自動的に値引きや営業連絡を行うわけではありません。
| 確認事項 | 確認する内容 |
|---|---|
| 最近の商談 | 提案中案件や次回発注予定があるか |
| 購買減少 | 季節性、一時的な需要変動、予算変更ではないか |
| 問い合わせ | 未解決課題や不満が残っていないか |
| 契約 | 更新時期・契約条件に変化がないか |
| 担当者 | 顧客側・自社側で担当変更がなかったか |
| 競合 | 競合製品・サービスの検討情報がないか |
| 顧客事情 | 組織再編、事業縮小、予算変更等がないか |
重要なのは、「離反しそうな顧客」と「施策によって離反を防げる顧客」は同じではないことです。離反予測研究でも、相関的な離反予測と、維持施策によって行動を変えられる顧客を推定する問題は区別されています(Mena et al., 2024)。
SaaSではRFMをどう読み替えるか
SaaSの場合、そのまま購入回数をFrequencyとする必要はありません。例えばRecencyを最終ログインからの日数、Frequencyを利用日数・主要機能利用回数、Monetaryを契約金額などへ読み替えられます。
問い合わせ件数に加えて、ログイン頻度の低下、利用席数、主要機能の利用率、契約更新日までの日数等を使うことも考えられます。
まずCRM・販売・問い合わせデータを結ぶ
顧客IDを軸に、購買履歴、売上、問い合わせ履歴を紐付けられれば、高度なAIモデルを構築する前でも、取引頻度が落ちている顧客や長期間購入がない顧客を整理できます。
- 自社における離反・休眠の定義を決める
- 顧客IDをCRM・販売管理・問い合わせ管理でそろえる
- 基準日時点のRFMを作成する
- 直近期間と過去期間の行動変化を計算する
- 問い合わせ・契約等の情報を結合する
- 観測期間後の離反結果を付与する
- 過去から未来の順でモデルを評価する
- 離反確率上位顧客を営業・CSが確認する
- 対応内容と結果を記録する
- 施策後に離反率・売上・継続率を再評価する
まとめ
顧客離反分析の目的は、AIに顧客対応を任せることではありません。売上がゼロになった後に気付くのではなく、取引状態の変化から「今確認すべき顧客」を整理することです。
今回の3,000件の人工例では、RFM、購買行動の変化、問い合わせ履歴を用いたロジスティック回帰で、将来評価データのROC-AUC 0.795、PR-AUC 0.530となりました。また、離反確率上位20%へフォロー対象を絞ると、実離反顧客の51.3%を含みました。
一方で、高リスクと判定された顧客が必ず離反するわけではなく、予測した離反を営業施策で防げるとも限りません。モデルは優先順位付けの入口として利用し、その後に商談、問い合わせ、契約、顧客事情を人が確認する必要があります。
SCI総合研究所株式会社のRASHINRAでは、CRM、顧客、商談、売上、問い合わせ等のデータを整理し、どの顧客・案件を優先して確認するかという意思決定へつなげます。
顧客数が多くフォロー対象を絞れない、休眠顧客を定量的に整理したい、SaaSの解約兆候を既存データから確認したいといった場合は、現在保有しているデータでどこまで分析可能かを整理するところから始められます。
参考文献
- Mena et al. 2024. Exploiting time-varying RFM measures for customer churn prediction with deep neural networks. Annals of Operations Research. Vol. 339. pp. 765-787. https://doi.org/10.1007/s10479-023-05259-9
- Hosmer, D. W., Lemeshow, S. and Sturdivant, R. X. 2013. Applied Logistic Regression. Wiley. 3rd ed. https://doi.org/10.1002/9781118548387
- Saito, T. and Rehmsmeier, M. 2015. The Precision-Recall Plot Is More Informative than the ROC Plot When Evaluating Binary Classifiers on Imbalanced Datasets. PLOS ONE. Vol. 10. Issue 3. Article e0118432. https://doi.org/10.1371/journal.pone.0118432
- Niculescu-Mizil, A. and Caruana, R. 2005. Predicting Good Probabilities with Supervised Learning. Proceedings of the 22nd International Conference on Machine Learning. pp. 625-632. https://doi.org/10.1145/1102351.1102430