
製造現場で品質不良が発生すると、品質担当者や生産技術担当者が、そのロットの温度、圧力、速度、材料、設備状態などを遡って確認することがあります。
しかし、不良が発生するたびに多数の工程ログを個別に調べる方法では、原因候補を絞り込むまでに時間がかかります。特に、温度だけ、圧力だけを見ても正常ロットとの境界が明確ではない場合、調査範囲はさらに広がります。
そこで考えたいのが、不良発生後にデータを探すだけではなく、製造時点で取得できる工程条件から「品質担当者が優先的に確認すべきロット」を事前に絞り込む方法です。
本記事では、5,000ロットの人工品質データを作成し、工程温度、工程圧力、工程速度の3条件をXGBoostへ入力して、「通常ロット」と「要確認候補」を分類します。さらにSHAPを用い、モデルがどの入力条件を判定に利用したかを確認します。
なお、本記事の工程条件、不良率、品質境界、モデル性能はすべて説明用の人工データに基づきます。実際の製造工程における品質基準や推奨工程条件を示すものではありません。
不良が発生してから原因を調べる運用の課題
品質不良の原因候補には、材料、設備、工程条件、作業条件など複数の要素があります。不良品が確認されてから関連データを集める場合、「どのロットで」「どの設備を使い」「どの条件で製造されたか」を改めて照合する必要があります。
一方、製造時点からロットIDを共通キーとして工程条件と品質結果を紐付けておけば、過去ロットから「どのような工程条件のときに要確認ロットが増えていたか」を分析できます。
Predictive Quality(予測的品質管理)は、製造プロセスやセンサーから得られるデータと製品品質を結び付け、品質をデータ駆動で推定する考え方です(Tercan and Meisen, 2022)。
工程条件と品質結果をロット単位でつなぐ
実務上は、工程条件だけでなく検査数と不良数を保持することも重要です。同じ不良率5%でも、20個中1個の不良と2,000個中100個の不良では、得られている情報量が異なります。
今回のケーススタディ:5,000ロットの人工品質データ
今回は製品A~C、設備2台を含む5,000ロットの人工データを作成しました。各ロットについて工程温度、工程圧力、工程速度、検査数量、不良数量、不良率を記録しています。
人工データでは、温度・圧力が製品ごとの通常条件から離れる、工程速度が高くなる、高温と高速条件が重なる、といった場合に不良発生リスクが確率的に増えるよう設定しました。
ただし、特定温度を超えれば必ず不良になるような決定論的なデータにはしていません。通常条件でも一定割合の不良が発生し、リスクの高い工程条件でも正常な品質結果となるロットを含めています。
今回は人工不良率が4%を超えたロットを「要確認候補」と定義しました。全5,000ロットの約10.9%が要確認候補となりました。4%という値は今回の説明用条件であり、実工場の品質基準ではありません。
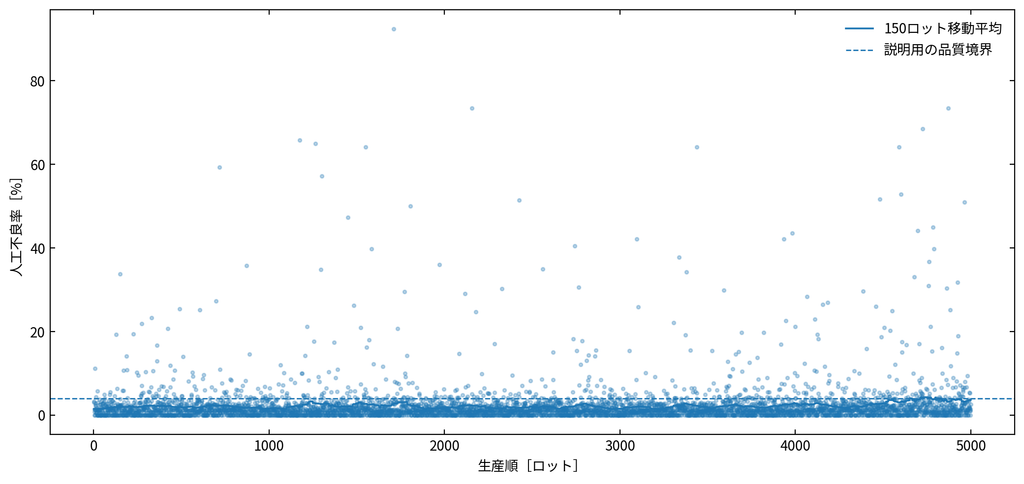
温度だけを見ても不良を分け切れない
まず工程温度と人工不良率を比較します。
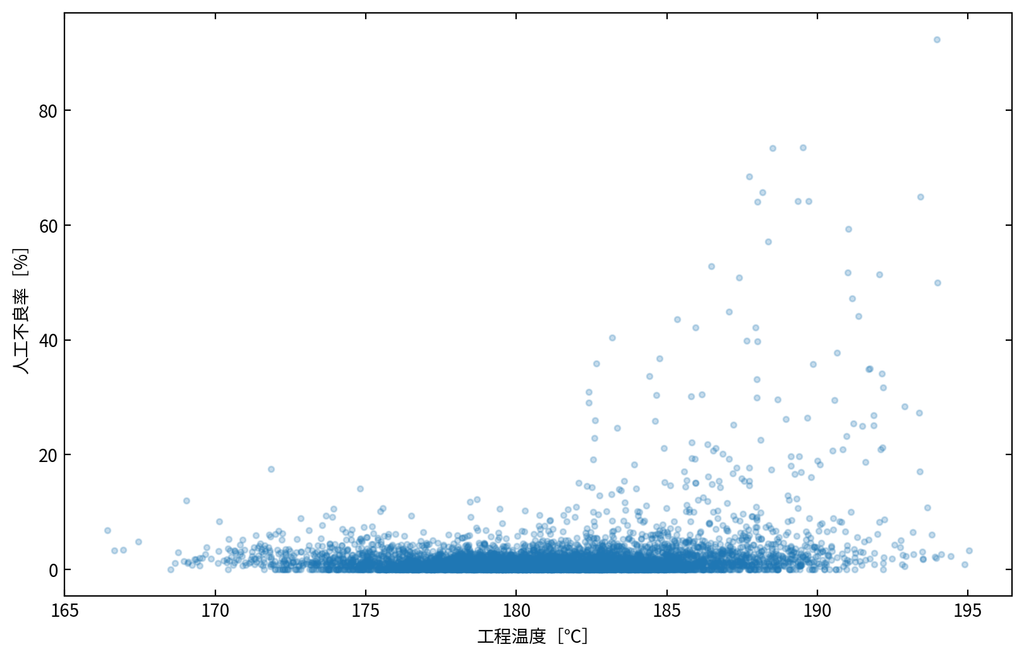
極端な工程条件で不良率が高いロットは存在しますが、温度だけでは通常ロットと要確認候補が広く重なっています。圧力や速度についても同様で、単一条件だけから明確な境界を引くことは難しい人工データになっています。
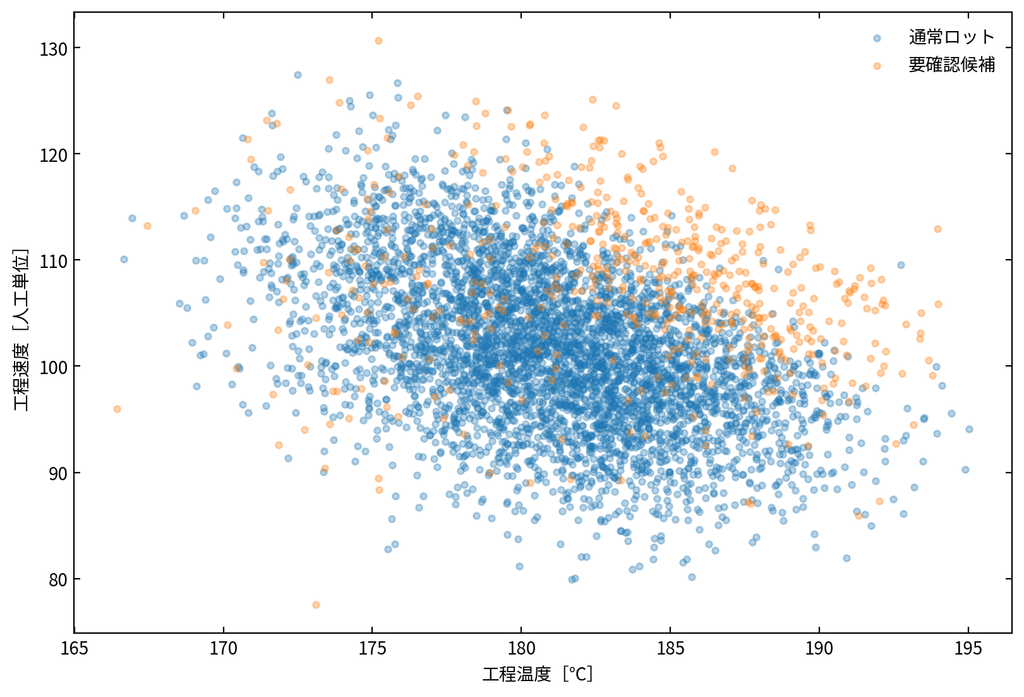
図3では、温度と速度を組み合わせることで状態差が少し見えやすくなりますが、それでも完全には分離されません。そこで今回は複数の工程条件を同時に扱える分類モデルを利用します。
今回は「不良率が基準を超えるロット」を分類する
「不良率を予測する」と言っても、分析方法は一つではありません。不良率そのものを数値として予測する回帰問題と、「要確認/通常」のように分類する方法があります。
今回は品質担当者が確認すべきロットを絞り込むことを目的とし、不良率4%超の人工ラベルを二値分類します。
モデル入力は工程温度、工程圧力、工程速度の3項目だけとしました。製品ID、設備ID、材料ロットも人工データには保存していますが、今回は分析を分かりやすくするためモデル入力から外しています。
実設備では、製品や設備によって通常条件が異なる場合、それらを無視して3変数だけで学習してよいとは限りません。
XGBoostで要確認ロットを予測する
分類モデルにはXGBoostを使用しました。XGBoostは決定木を逐次的に組み合わせる勾配ブースティングを効率的に実装した手法です(Chen and Guestrin, 2016)。
モデル評価では、ロットを無作為に混ぜるのではなく、生産順で分割しました。1~3,500ロットを学習用、3,501~4,250ロットを検証用、4,251~5,000ロットを最終評価用としています。
これは「過去データから将来ロットを判定する」という実運用に近づけるためです。また、分類の判定閾値は検証データ上でF1が高くなる位置を選び、今回の人工条件では0.36となりました。
この0.36はモデルの説明用判定閾値であり、「36%の確率で不良になる」という意味ではありません。
Accuracyだけでは品質予測モデルを評価できない
評価用750ロットでは119ロットが人工ラベル上の要確認候補でした。
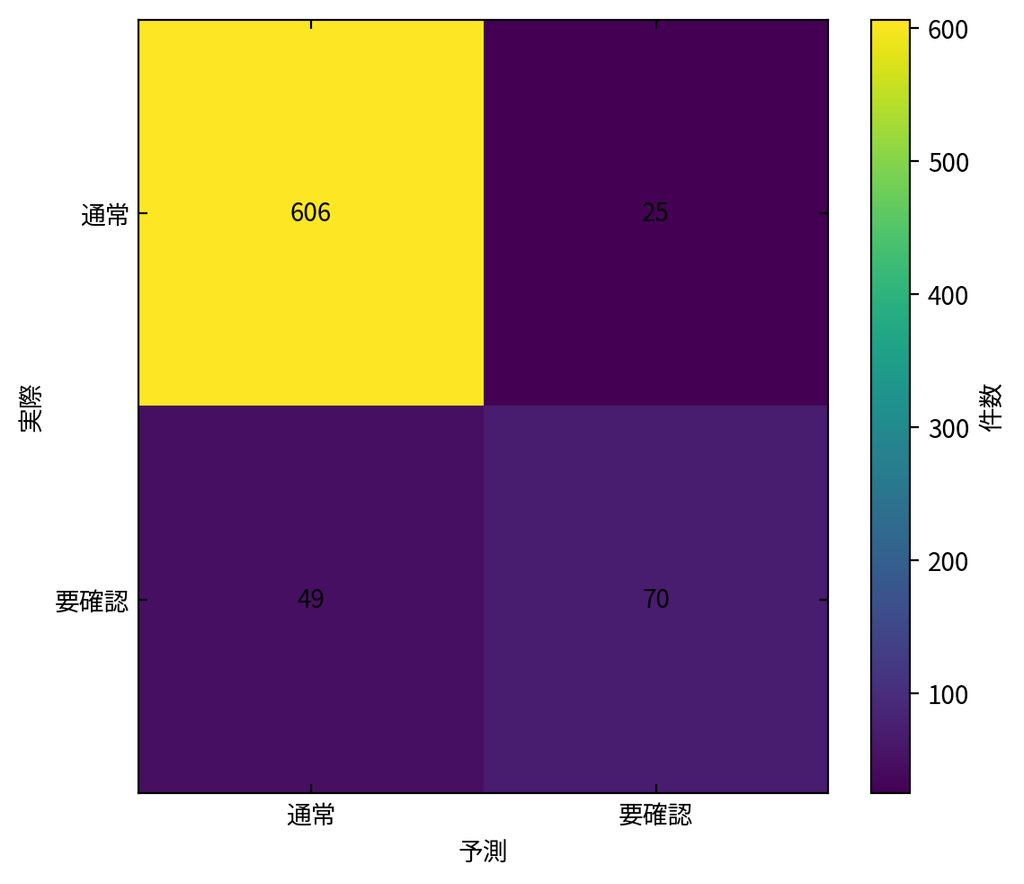
通常ロット631件のうち606件を通常と判定し、25件を要確認候補と判定しました。一方、実際の要確認候補119件では70件を検出しましたが、49件を通常と判定しています。
| 評価指標 | 人工評価データでの結果 |
|---|---|
| Accuracy | 0.901 |
| Precision | 0.737 |
| Recall | 0.588 |
| F1 | 0.654 |
| ROC-AUC | 0.882 |
| PR-AUC | 0.732 |
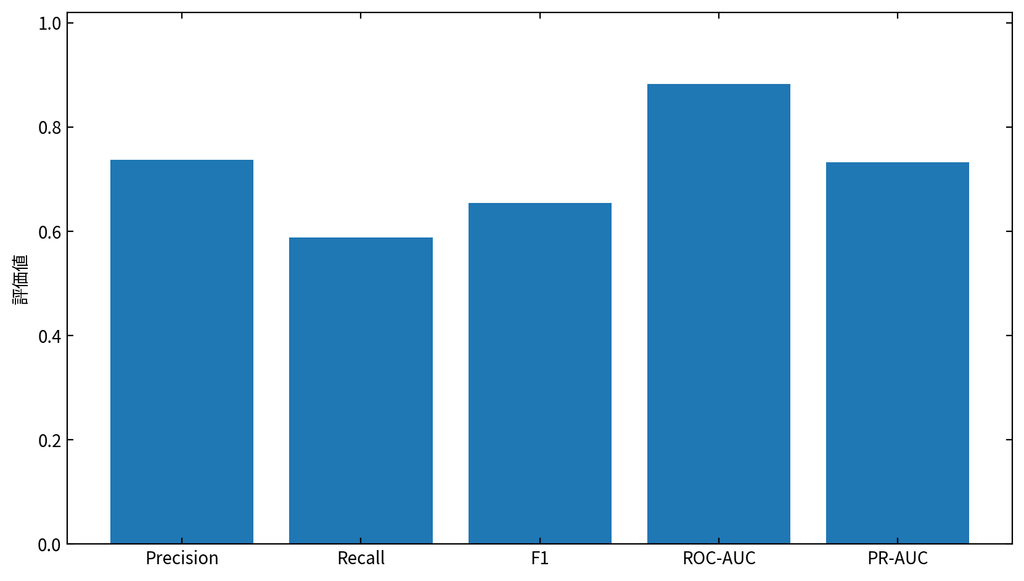
Accuracyは約0.90ですが、それだけを見てモデルが十分と判断することはできません。今回の目的では、要確認ロットの見逃しを示すRecallと、要確認と判定した中で実際に対象だった割合を示すPrecisionの双方が重要です。
検査・原因調査の工数を減らしたい場合はPrecisionが重要になります。一方、品質リスクの高いロットをできるだけ拾いたい場合はRecallを重視する必要があります。実運用では、見逃しコストと確認工数のバランスから判定条件を決めます。
SHAPでモデルが使った工程条件を確認する
分類精度だけでは、「なぜそのロットが要確認候補になったのか」を品質担当者へ説明しにくい場合があります。
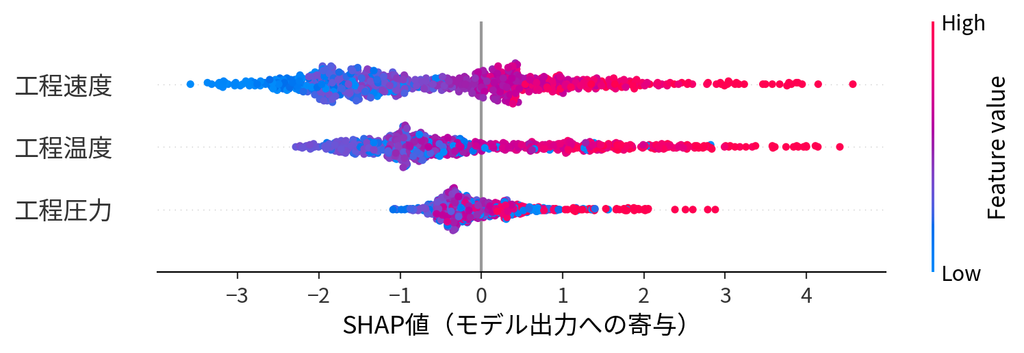
そこで今回はSHAP(SHapley Additive exPlanations)を利用しました。SHAPは、モデルの個々の予測に対して各特徴量がモデル出力をどちら向きに、どの程度動かしたかを表す説明手法です(Lundberg and Lee, 2017)。
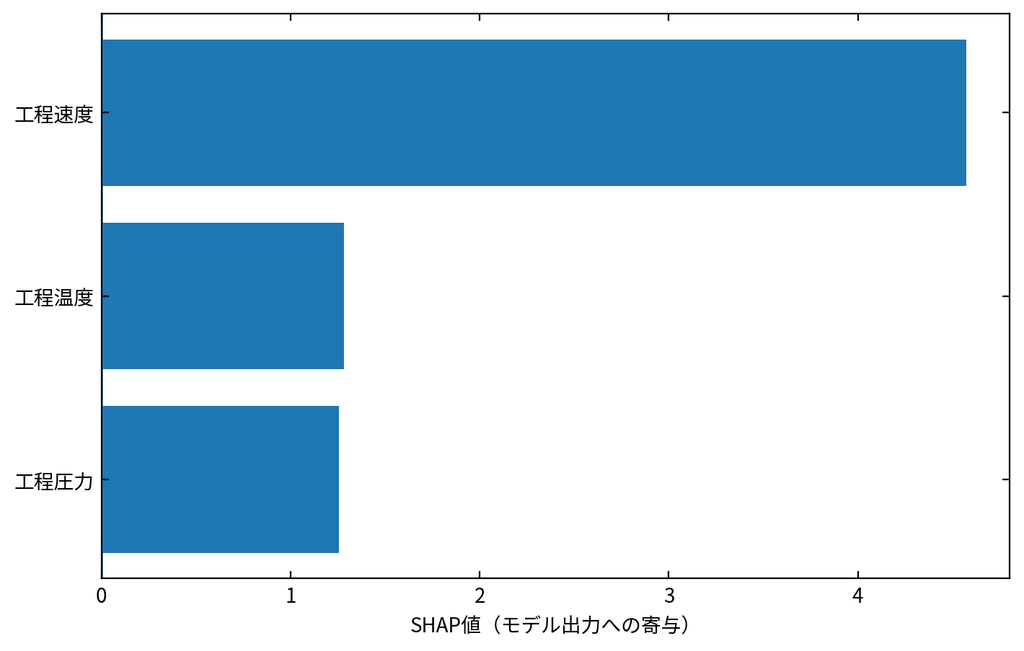
今回の人工データでは、平均絶対SHAP値は工程速度、工程温度、工程圧力の順となりました。これは今回生成した人工データと学習モデルにおいて、工程速度がモデル判定に比較的大きく利用されたことを示します。
SHAPは不良原因を証明するものではない
ここで最も注意したいのが、SHAP値を不良原因の寄与率として解釈しないことです。
例えば工程速度のSHAP値が大きくても、「速度を下げれば不良が減る」とは限りません。速度と材料ロットが連動していた、設備ごとの運用条件が異なっていた、モデルに入力していない別条件が同時に変化していた、といった可能性があります。
例えば人工ロットNo.4758では、要確認スコアが0.992となり、工程速度、工程温度、工程圧力がいずれもモデル出力を要確認側へ押し上げていました。実際の人工不良率も約30.9%でした。
しかし、この結果から3条件が因果的な不良原因だったと結論付けることはできません。SHAPは「モデルが何を見て判定したか」を確認し、その後の現場調査を絞り込むために利用します。
製品・設備条件を無視しない
今回のモデルは説明を単純化するため、温度・圧力・速度だけを使用しました。しかし実設備では、同じ180℃でも製品Aでは通常、製品Bでは低温という場合があります。
製品、材料、設備、レシピ、シフト等によって通常条件が異なる場合は、対象を分ける、条件情報を入力する、基準からの差へ変換するなどの対応が必要です。
また、設備改造やメンテナンス、材料変更等でデータ分布が変われば、過去モデルの性能が維持されるとは限りません。モデル導入後も継続的な評価が必要です。
モデル判定後に人が確認する項目
表1 要確認候補となったロットで確認したい情報
| 確認項目 | 確認したい内容 |
|---|---|
| 材料ロット | 原材料・部材の変更やロット差がないか |
| 設備 | 設備固有の傾向やアラームがないか |
| 工程レシピ | 設定条件やプログラム変更がないか |
| 温度・圧力履歴 | 平均値だけでなく工程中の変動がないか |
| 速度変更 | 生産性向上等を目的とした条件変更がないか |
| 保全履歴 | 部品交換や調整の前後で変化していないか |
| 作業シフト | 作業方法・段取り等の条件差がないか |
| 不良モード | 同じ種類の不良が増えているか |
| 前後ロット | 単発事象か継続事象か |
ロットIDを介して工程温度・圧力・速度と検査結果を紐付けられる場合は、新しいAIシステムを導入する前に、まず既存データから不良が発生しやすい条件を整理できる可能性があります。
まず1製品・1工程からPoCする
- 対象製品・工程を1つ選ぶ
- ロットIDと工程条件・品質結果を紐付ける
- 検査数と不良数を確認する
- 温度・圧力・速度と不良率を可視化する
- 製品・設備・材料条件の違いを整理する
- 過去データと将来評価データを時間順に分ける
- 単純な基準と機械学習モデルを比較する
- Precision・Recall・PR-AUC等を確認する
- モデル判定と実際の工程履歴を照合する
- 現場で使える確認件数まで絞れるか評価する
重要なのはモデル精度だけではなく、「品質担当者が確認すべきロットや工程条件を現実的な範囲まで絞れるか」を評価することです。
まとめ
工程条件と品質結果をロット単位で紐付けることで、不良が発生してから工程ログを探すだけではなく、過去データから要確認ロットを事前に絞り込める可能性があります。
今回の5,000ロットの人工例では、温度・圧力・速度の3条件からXGBoostで要確認候補を分類し、評価データでPrecision 0.737、Recall 0.588、F1 0.654、ROC-AUC 0.882、PR-AUC 0.732となりました。
一方、119件の要確認候補のうち49件は見逃しており、モデルだけで品質判定や検査を置き換えられる結果ではありません。モデルはあくまで確認対象を絞るための補助情報として扱う必要があります。
またSHAPを使えばモデルがどの工程条件を判定へ利用したか確認できますが、それだけで不良原因を証明することはできません。工程・材料・設備・保全・品質履歴との照合が必要です。
SCI総合研究所株式会社のMIRASENTでは、「不良発生後の原因調査に時間がかかる」「工程条件ログと品質結果を活用したい」「既存データで品質予測が可能か確認したい」といった段階から、データの整理と分析可能性を検討できます。
既存の工程条件、品質記録、製品・材料情報、設備情報等を確認しながら、現在のデータで可能な分析、追加取得が必要な情報、不良予測・品質要因分析の進め方を整理します。
参考文献
- Tercan, H. and Meisen, T. 2022. Machine learning and deep learning based predictive quality in manufacturing: a systematic review. Journal of Intelligent Manufacturing. Vol. 33. pp. 1879-1905. https://doi.org/10.1007/s10845-022-01963-8
- Chen, T. and Guestrin, C. 2016. XGBoost: A Scalable Tree Boosting System. Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining. pp. 785-794. https://doi.org/10.1145/2939672.2939785
- Lundberg, S. M. and Lee, S.-I. 2017. A Unified Approach to Interpreting Model Predictions. Advances in Neural Information Processing Systems. Vol. 30. pp. 4765-4774. https://papers.nips.cc/paper/2017/hash/8a20a8621978632d76c43dfd28b67767-Abstract.html